LLM推理泛化性最全综述库
推荐指数 49.0 NO. 008 · 2026.09.12
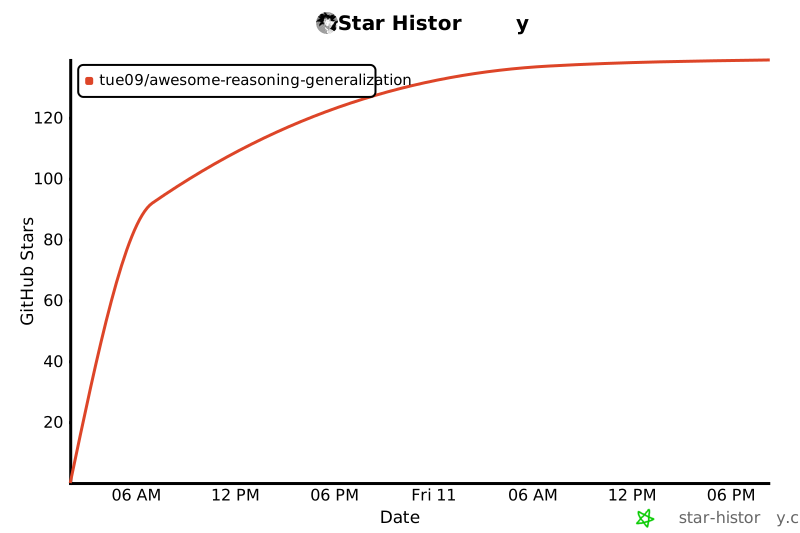
Stars139创建1 天前Forks4Issues0
为什么值得看
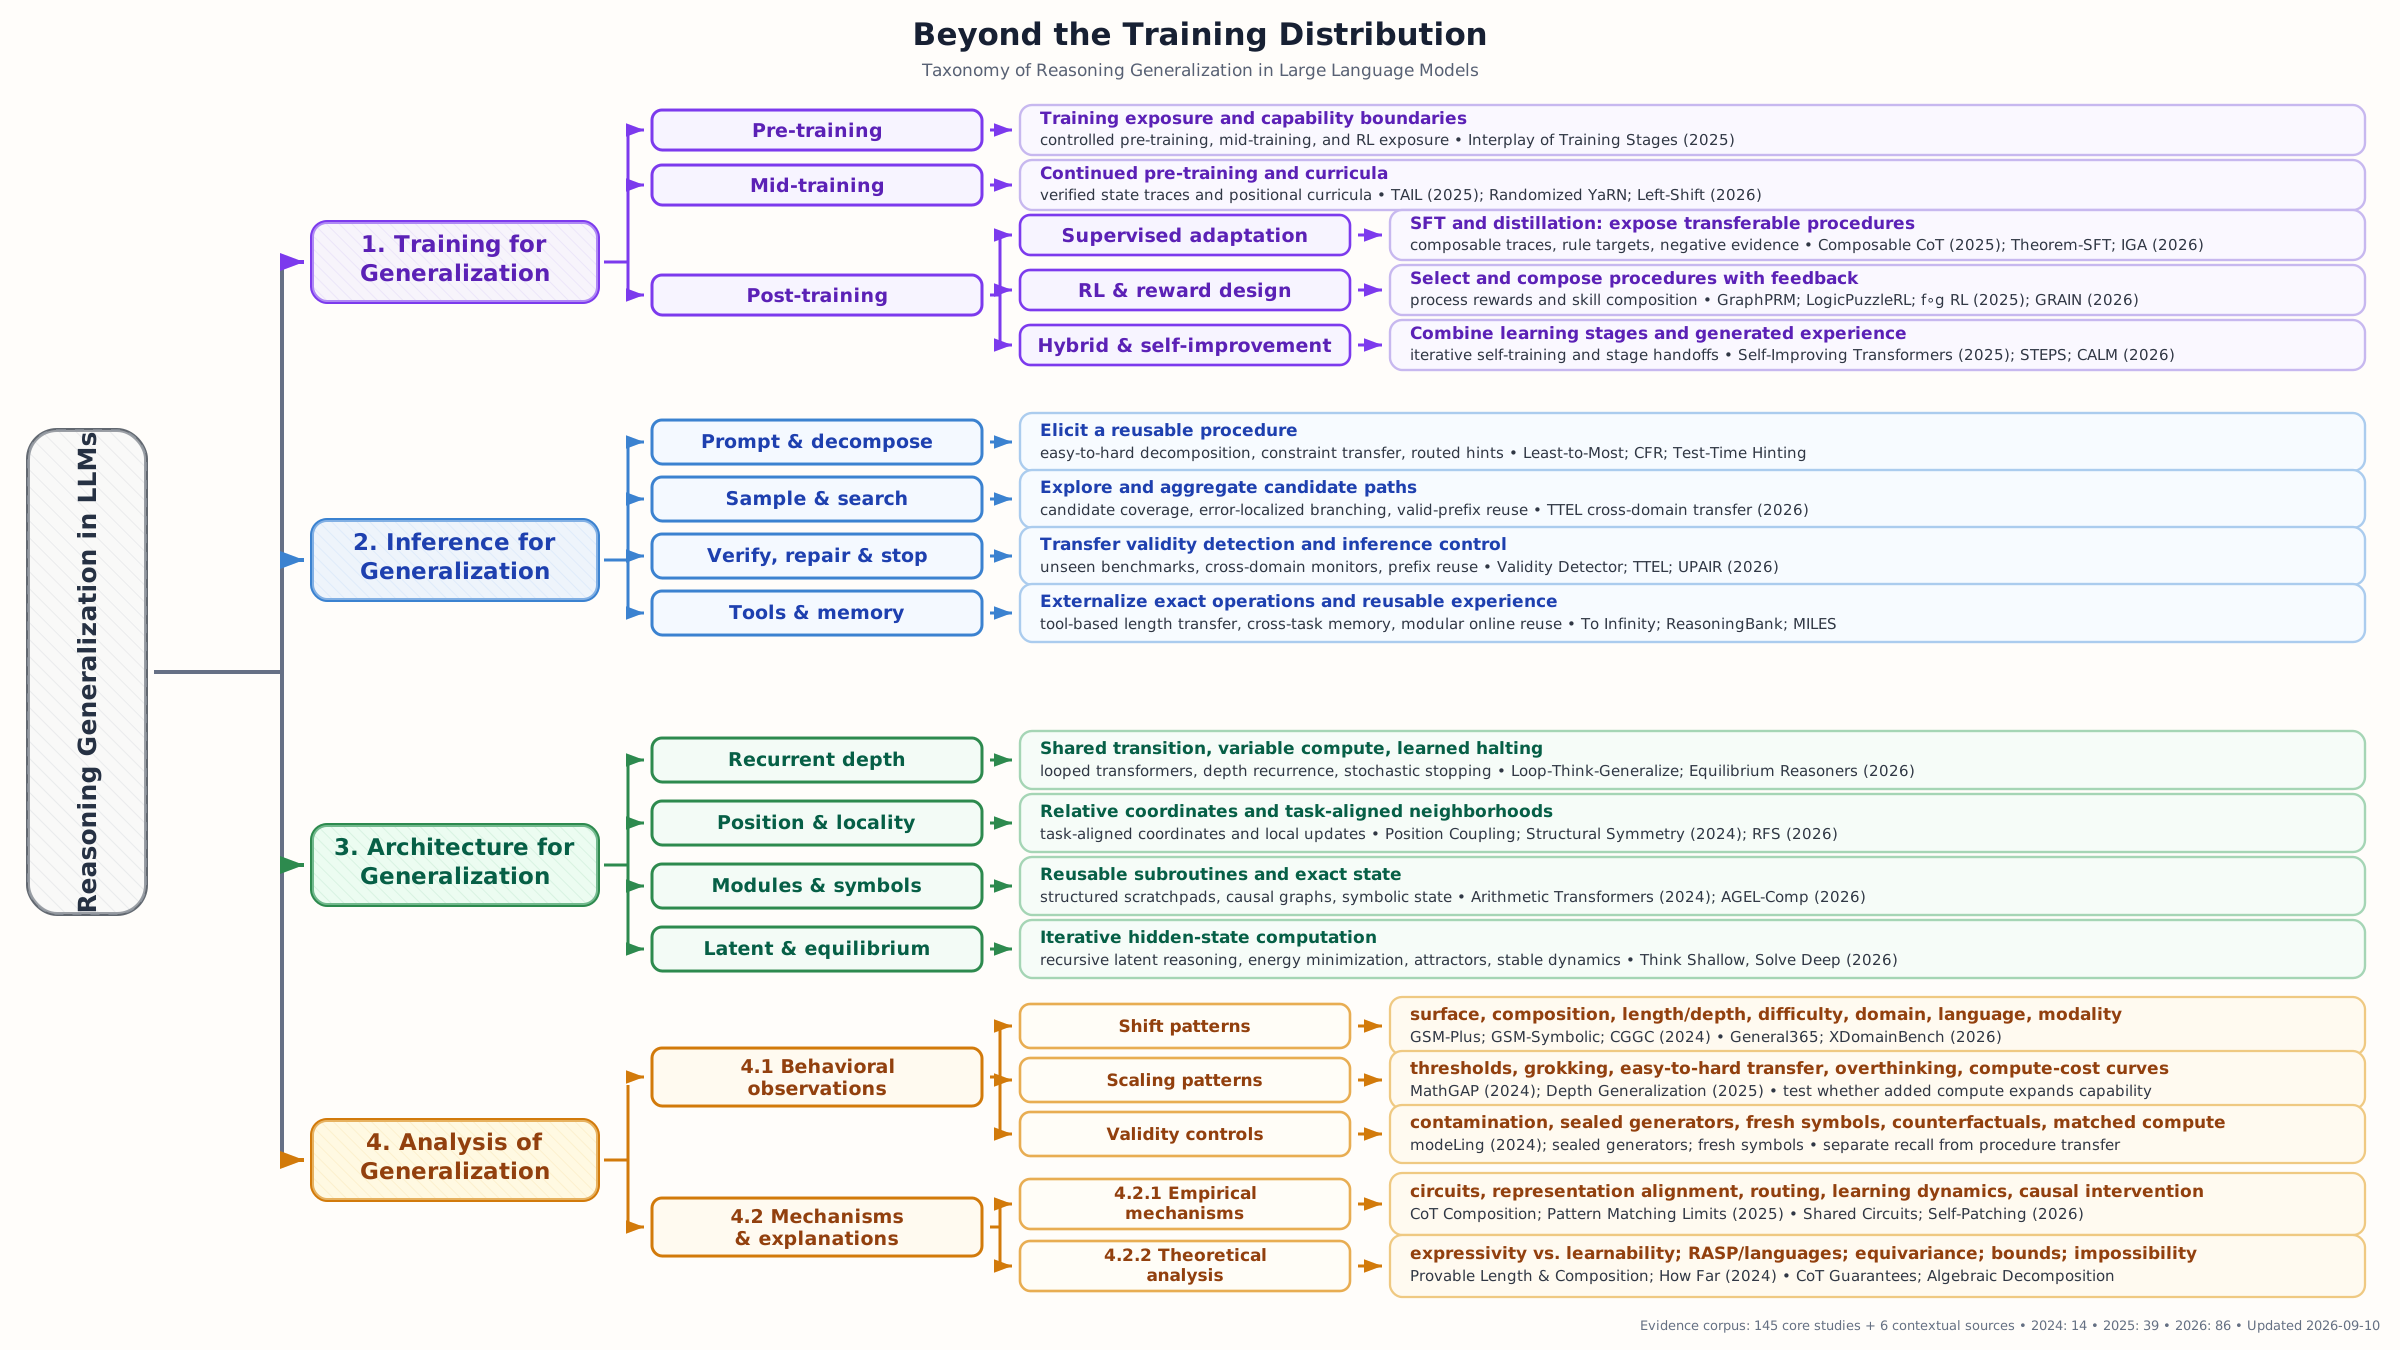
收录145篇核心研究的推理泛化综述仓库,系统梳理预训练、SFT、RL及推理阶段提升泛化的方法。做Agent或复杂推理系统的团队可直接按图索骥,避免重复踩坑。
Awesome paper list for reasoning generalization in LLMs.
媒体预览
编辑判断
这个仓库的价值不在综述本身,而在它的分类框架——把推理泛化拆成训练阶段和推理阶段两条线,尤其是把"self-improvement"和"hybrid"单独列为一类,说明社区已经意识到纯RL或纯SFT都不够。
目前做推理增强的团队大多盯着DeepSeek-R1或OpenAI的o系列,但这145篇论文里有不少被忽视的轻量方案,比如用合成数据做mid-training、用过程奖励模型做推理时搜索,这些对算力有限的创业团队更实际。
建议直接跳到"Post-training: RL and reward design"和"Inference-time generalization"两部分,先看2026年的论文,再倒查引用链。
Star History
生态分析
Beta
推理泛化领域首个系统性论文索引,填补LLM鲁棒性研究的知识整合空白。
独特价值:聚焦推理泛化细分方向,提供从预训练到推理阶段的全链路方法图谱。