RL训练数据策略:简单均匀采样竟最优
推荐指数 81.0 NO. 022 · 2026.09.15
upvotes96comments1
为什么值得看
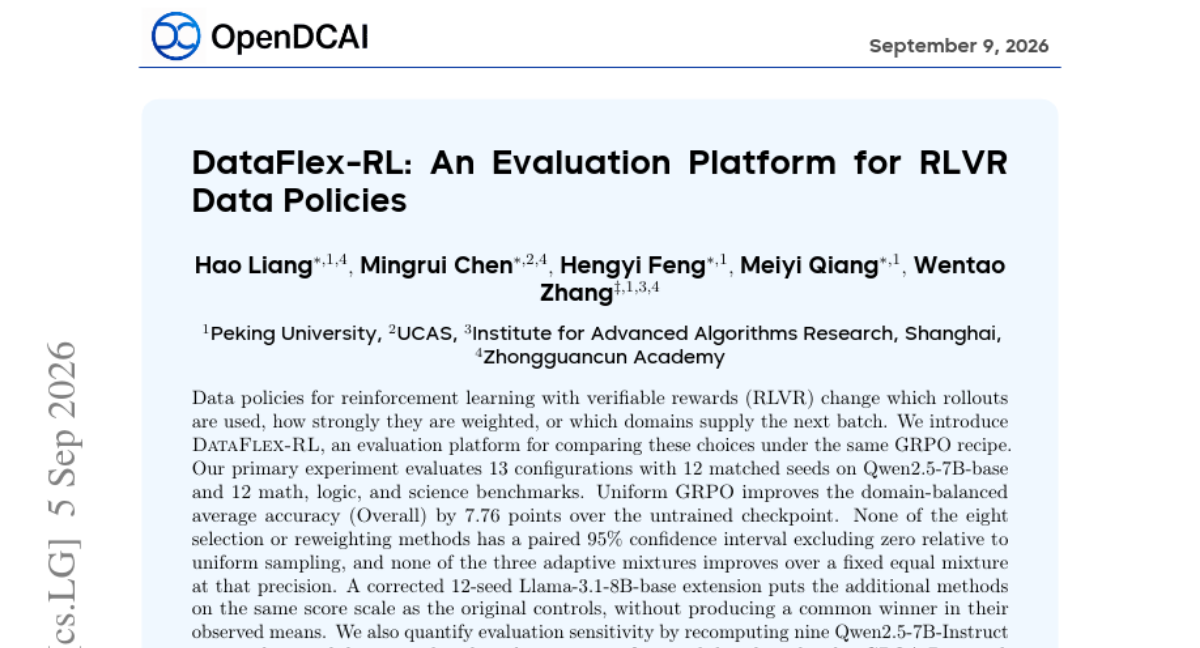
DataFlex-RL 系统评估了 13 种 RLVR 数据策略,发现均匀采样在数学、逻辑、科学基准上匹配或超越了自适应选择、重加权等复杂方法。这对正在调数据配比的大模型训练团队有直接参考价值,可能省下大量无效实验。
媒体预览
编辑判断
这个发现有点反直觉——业内普遍在卷各种自适应数据策略,比如 DeepSeek 的 GRPO 实践中就涉及复杂的难度筛选和在线采样。DataFlex-RL 用 12 个种子和 12 个基准的严格对照说明,这些复杂度可能都是 over-engineering。
均匀采样胜出的一个可能解释是:RLVR 的奖励信号本身已经足够强,额外的数据筛选反而引入了方差。这对工程团队的直接启示是,先跑通最朴素的基线再叠加花哨策略,而不是反过来。
平台代码和配置已开源,如果你团队正在用 GRPO 或 PPO 做 post-training,建议直接拿他们的 13 种配置做 ablation,避免重复踩坑。