模型对齐动态切换,无需重训
推荐指数 64.0 NO. 007 · 2026.11.03
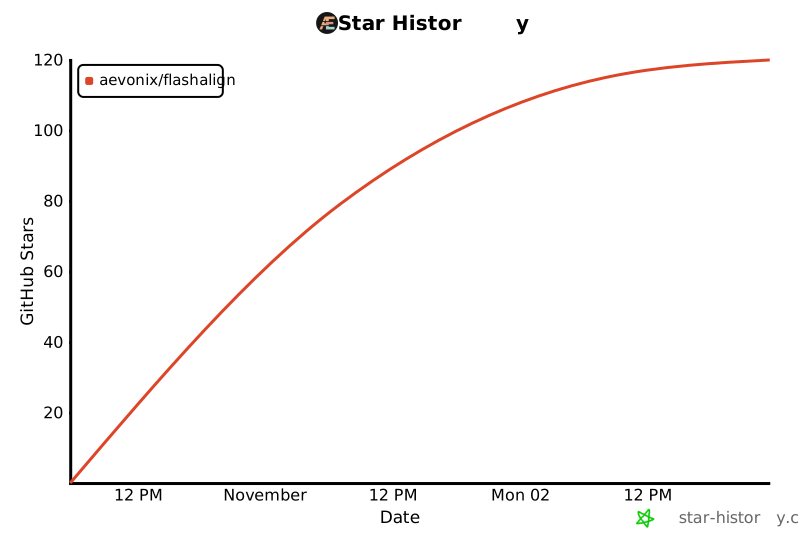
Stars120创建2 天前Forks13Issues0
简介
FlashAlign 支持在推理时按需加载不同对齐配置(如降低或增强拒绝回答),且无需永久修改模型权重,兼容量化模型。对需要灵活控制模型安全边界的推理服务商和私有化部署团队有直接价值。
ReAlign models instantly, on demand. Per-request alignment for verified users and channels, or Always On. Use directly or with Hermes, OpenClaw and custom harnesses.
媒体预览
编辑判断
当前业界处理模型过度拒绝的主流做法是直接微调或永久修改权重,但这对需要服务多类用户(如内部员工 vs 外部客户)的厂商很不灵活。FlashAlign 的路由层设计让人联想到 vLLM 的 LoRA 动态加载,但它针对的是对齐空间而非任务适配。
与直接竞品相比,Unsloth 的 abliteration 需要手动改权重,Azure 的内容过滤是外挂规则层,FlashAlign 的优势在于把对齐粒度下沉到单次请求且保持权重干净。如果你的推理平台需要给不同租户配置差异化的安全策略,或者想快速 A/B 测试对齐效果,这个工具比重新跑 SFT/DPO 便宜得多。
不过要注意它目前只支持 NVIDIA GPU 和 Linux,DGX Spark 的兼容性还在验证中,生产部署前建议先确认你的引擎版本是否在支持列表。
Star History
生态分析
Experimental
推理时动态对齐配置工具,填补永久模型修改与灵活安全策略间的空白
独特价值:无需改权重即可按请求切换对齐策略,兼容量化模型与多推理后端