Agent自进化防过拟合正则化方案
推荐指数 76.0 NO. 024 · 2026.09.23
upvotes151comments1
为什么值得看
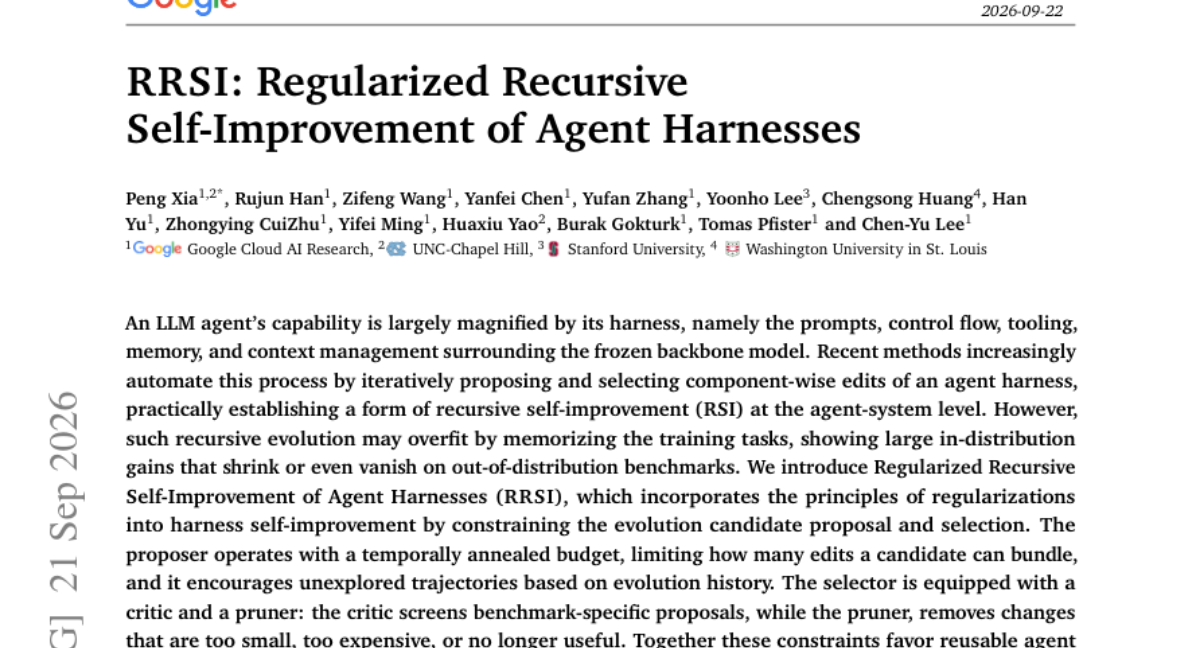
RRSI在Agent系统的递归自我改进中引入正则化约束,解决进化过程中对训练任务过拟合、分布外性能崩塌的问题。对正在构建自动优化Agent管线的团队有直接参考价值,避免陷入"训练集上自我感动"的陷阱。
媒体预览
编辑判断
当前Agent自动优化赛道火热,从DSPy到AutoGPT的各种变体都在做类似的事,但很少有人系统性地讨论过拟合问题。这篇论文的洞察在于把深度学习里的正则化思想迁移到系统层面——不是约束模型权重,而是约束对prompt、工具调用、控制流的修改空间。
实验显示不加正则化的RSI在分布内任务提升27%,但分布外暴跌15%;RRSI把分布外差距收窄到3%以内。这个trade-off很真实,做过生产级Agent调优的人应该都遇到过。
代码尚未开源,但方法本身不复杂,核心是一个基于验证集增益+复杂度惩罚的候选筛选函数,有现成Agent框架的团队可以较快复现。