1M参数OCR跑49页/秒,干翻Tesseract
推荐指数 64.0 NO. 005 · 2026.10.15
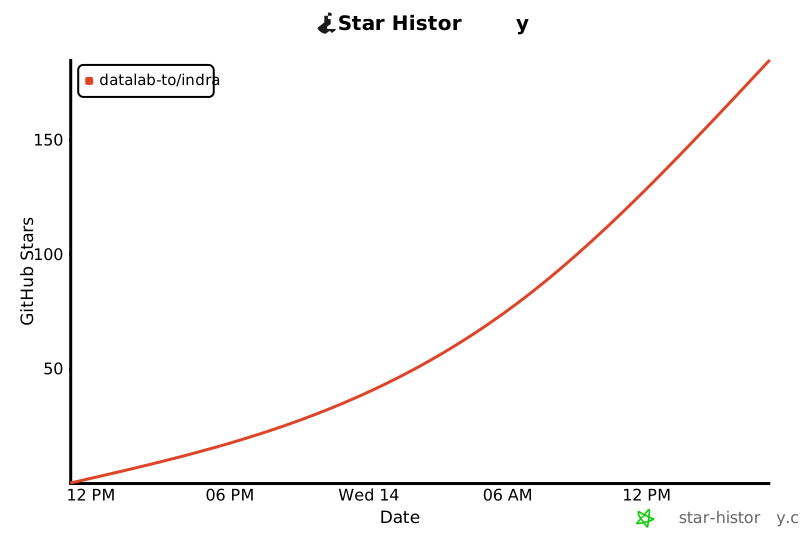
Stars196创建1 天前Forks14Issues1
为什么值得看
Indra OCR是一个仅1M参数的轻量级OCR模型,在CPU上可达49页/秒吞吐量,准确率超越PaddleOCR和Tesseract。对需要本地部署、低成本文档解析的AI工程师和创业者极具吸引力。
Fast CPU OCR: line detection, CTC recognition, reading order, markdown
媒体预览
编辑判断
OCR赛道长期被Tesseract和PaddleOCR垄断,但前者准确率掉队,后者虽强却依赖GPU和复杂流水线。Indra的破局点在于用极小的模型体积(1M参数)实现了CPU上的实时推理,这对SaaS化文档处理产品尤为关键——可以砍掉GPU成本直接按CPU实例定价。
需要警惕的是,OmniParseBench的评测维度偏向文本提取,表格、公式等复杂版式的鲁棒性尚待验证。如果你的业务以标准文档(合同、发票、论文)为主,建议先用它替换Tesseract做AB测试;若涉及多栏混排或扫描件,建议观望社区反馈再迁移。
Star History
生态分析
Beta
CPU端极致轻量OCR基础设施,填补边缘部署空白
独特价值:1M参数+49页/秒CPU吞吐,准确率超主流方案
竞品: