蒸馏时on-policy未必更好
推荐指数 72.0 NO. 023 · 2026.10.03
upvotes100comments1
为什么值得看
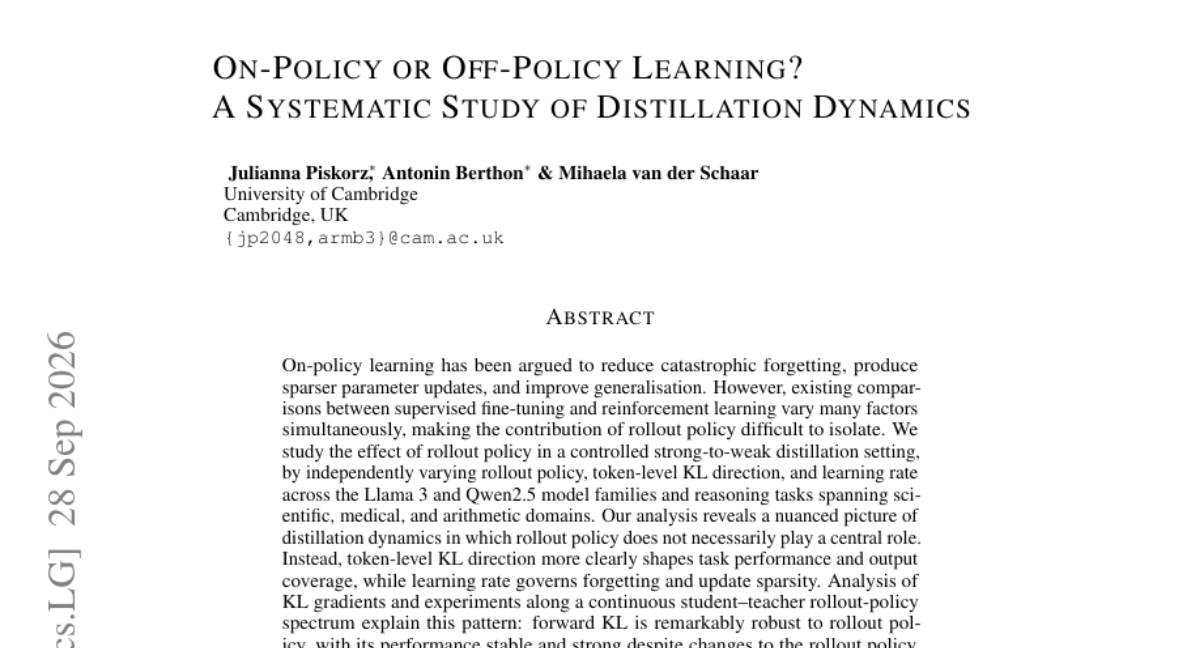
HuggingFace团队系统控制了rollout policy、KL方向和LR三个变量,在Llama3和Qwen2.5上对比了on-policy与off-policy蒸馏效果。发现之前认为on-policy更优的结论可能是混淆变量导致的,实际选择需看具体场景。
媒体预览
编辑判断
这篇论文的实验设计值得学习:之前很多研究把SFT和RLHF混着比,变量没控住,结论自然可疑。这里把rollout policy单独拆出来,配合token-level KL方向一起调,才看清真相。
实际做模型蒸馏的团队常默认用on-policy采样,这篇说明off-policy配合合适的KL约束可能更省算力且效果不差。如果你在用DPO或KTO做对齐,可以重新审视自己的采样策略。
代码和配置看起来会开源,等放出后可以重点跑一下医疗推理那个子集,那个领域的蒸馏痛点最典型。