免梯度修复LLM推理死循环
推荐指数 79.0 NO. 026 · 2026.11.12
upvotes72comments1
简介
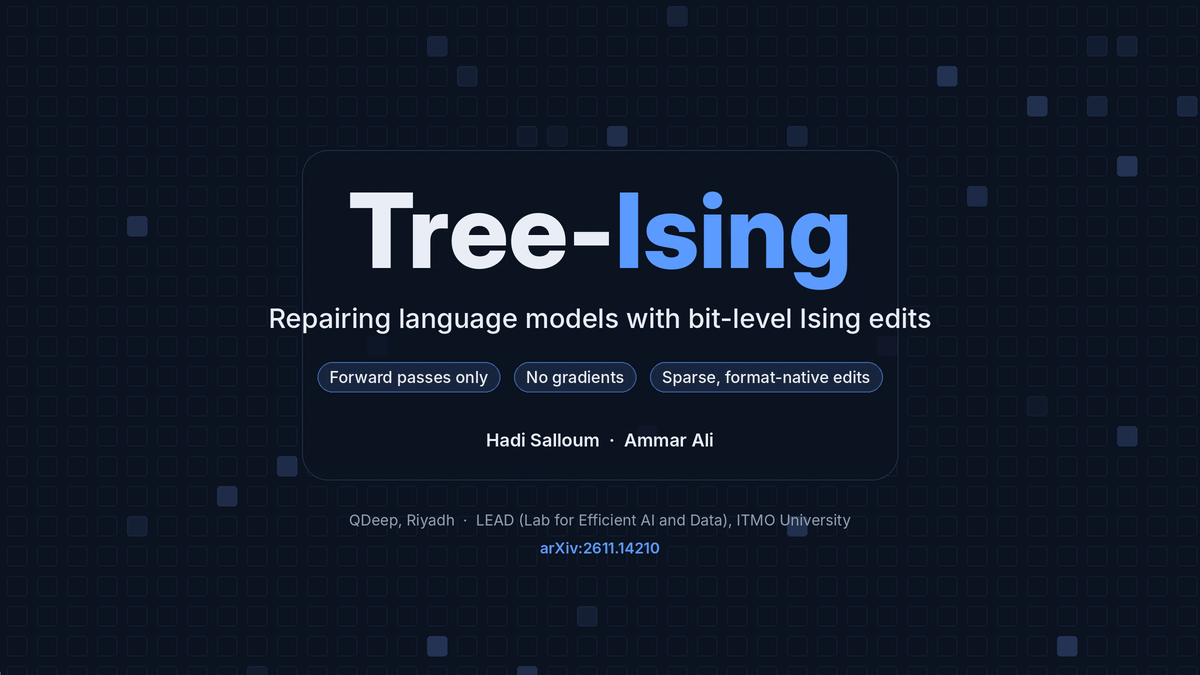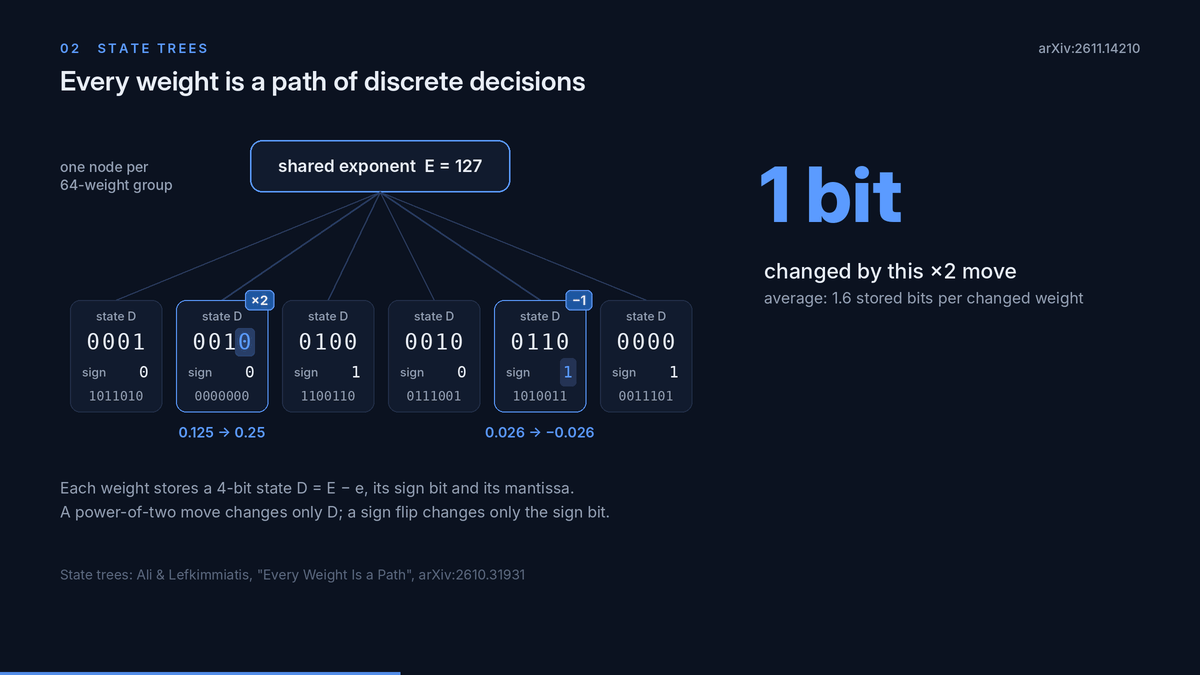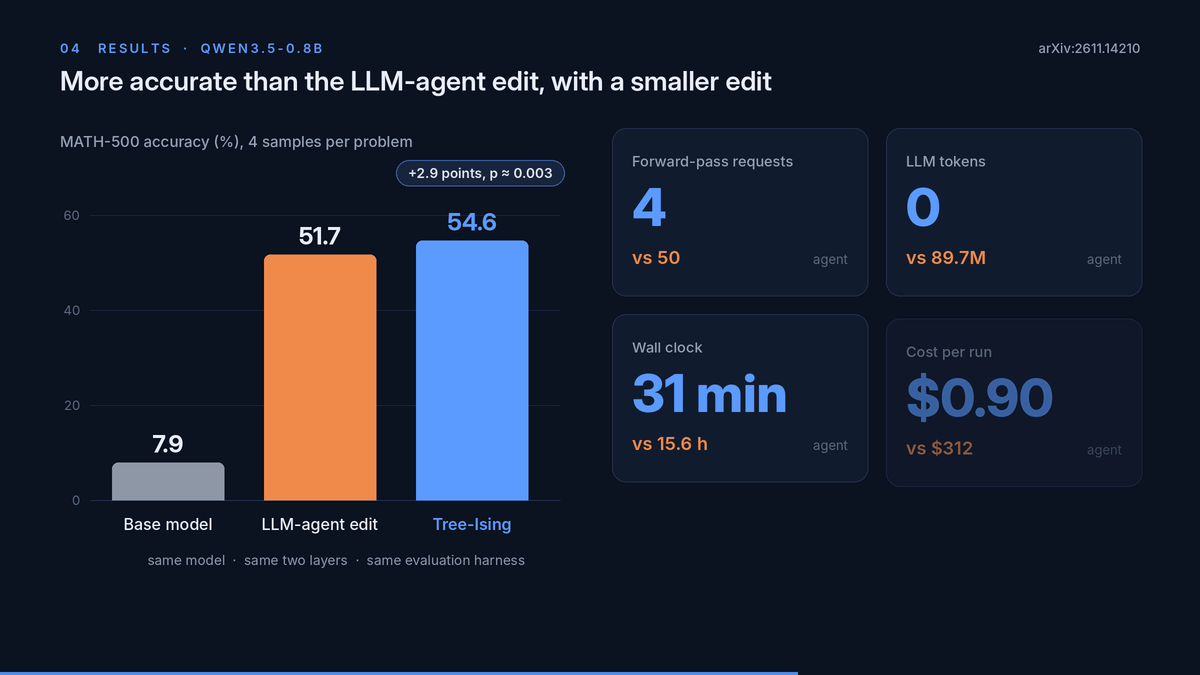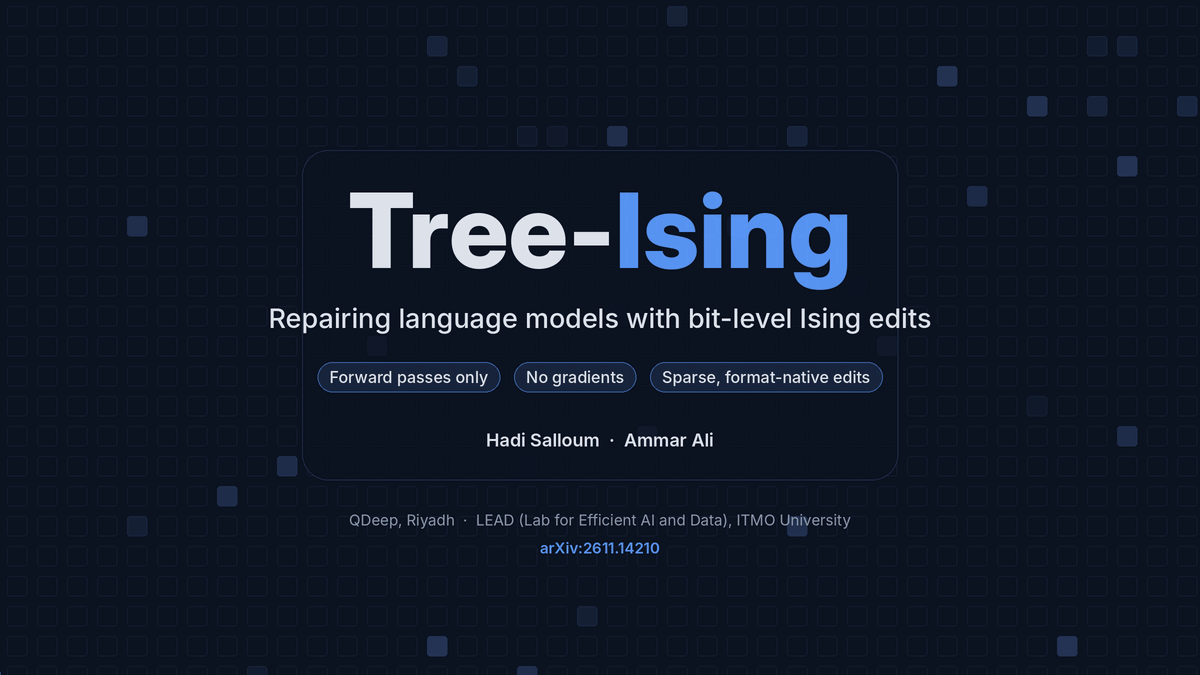
Tree-Ising将LLM权重修复转化为稀疏Ising/QUBO离散优化问题,直接在BF16参数层面操作,无需梯度计算或调用LLM API。相比MIT近期工作需要158轮agent交互、近9000万token,该方法以零token成本实现更高精度的数学推理修复,对模型部署后的在线纠错极具吸引力。
媒体预览
编辑判断
MIT那篇weight-space programming工作本质上是用一个更强的GPT-6去'教'一个更弱的Qwen怎么改权重,agent成本极高且不可扩展。Tree-Ising的聪明之处在于绕开了这个'以强训弱'的范式,把问题变成了纯数学优化——用模型自己的前向统计定义目标函数,求解稀疏比特翻转。
这意味着两件事:一是修复过程完全离线、零API依赖,适合端侧和私有化部署场景;二是QUBO求解器本身正在快速进化(D-Wave、富士通的数字退火机),硬件加速可能让这种方法在毫秒级完成。如果作者开源了QUBO问题的构造代码,做模型压缩和部署的团队应该优先跟进,这比传统的LoRA微调或RAG补丁更适合修复已部署模型的特定故障模式。