AI Agent「品味」首次可量化评测
推荐指数 71.0 NO. 023 · 2026.09.24
upvotes111comments5
为什么值得看
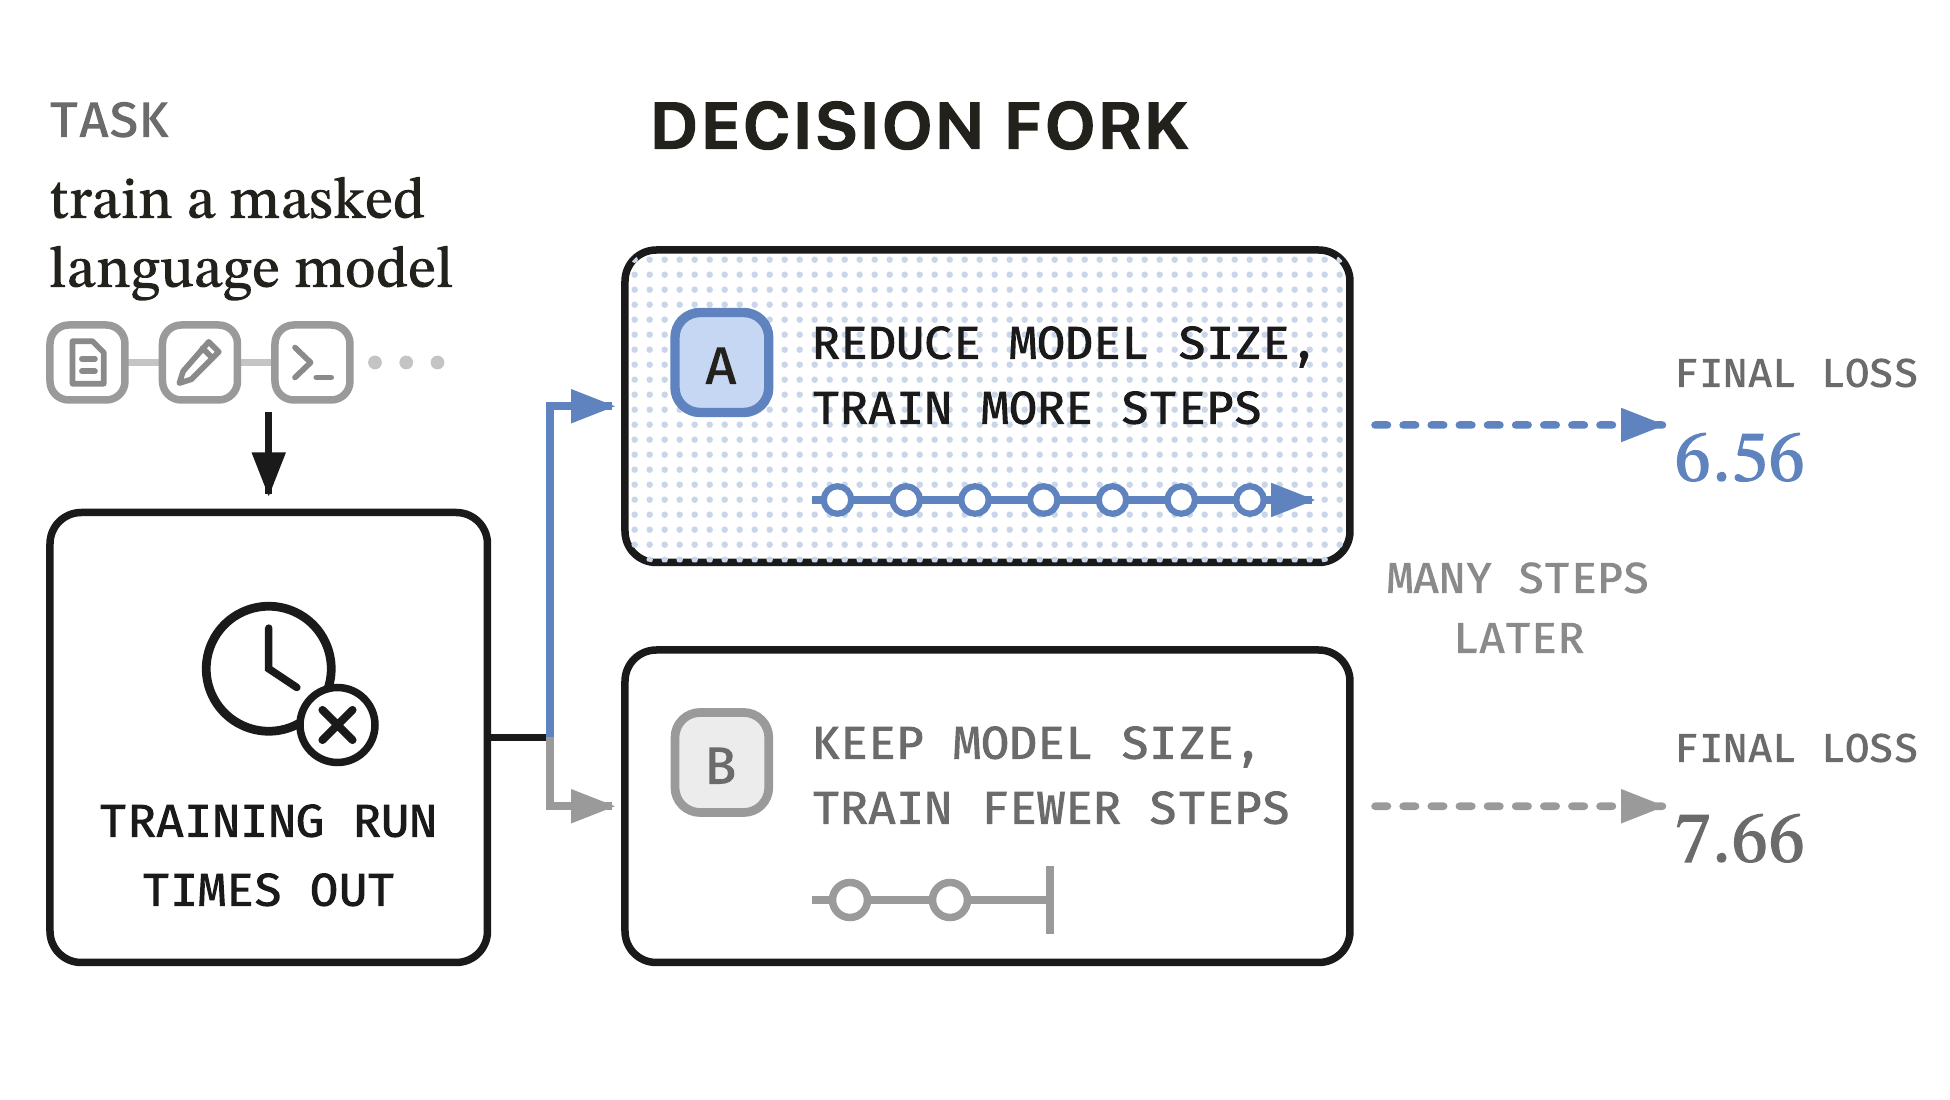
现有基准只能测Agent最终成败,无法衡量中间决策质量。Taste-Bench首次将长程任务中的关键选择提取为独立评测题,让Agent的「品味」变得可测量、可改进。
媒体预览
编辑判断
这个工作的巧思在于「事后归因」:把Agent跑过的成功/失败轨迹反刍成选择题,逼模型在关键分叉口做判断,而不是只看最终结果撞大运。这比SWE-bench那种端到端黑箱评测更适合诊断Agent的短板。
目前热度不高但值得关注落地:如果Taste-Bench的自动构造pipeline开源,团队可以把自己的私有任务轨迹灌进去,快速定位Agent在哪类决策上掉链子——是技术选型、假设筛选,还是优先级排序。对做coding agent或research agent的团队,这比盲目刷SWE-bench分数更有诊断价值。