小模型浅层做分类,标签省90%
推荐指数 64.0 NO. 007 · 2026.09.24
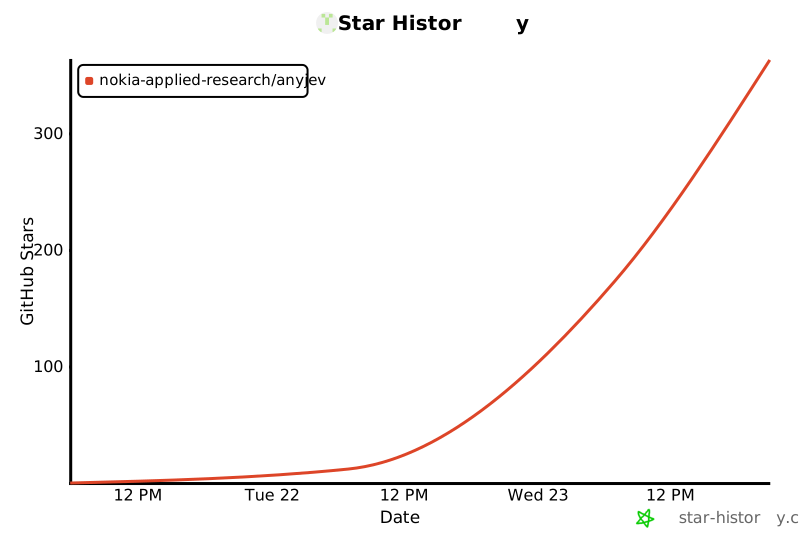
Stars363创建2 天前Forks60Issues3
为什么值得看
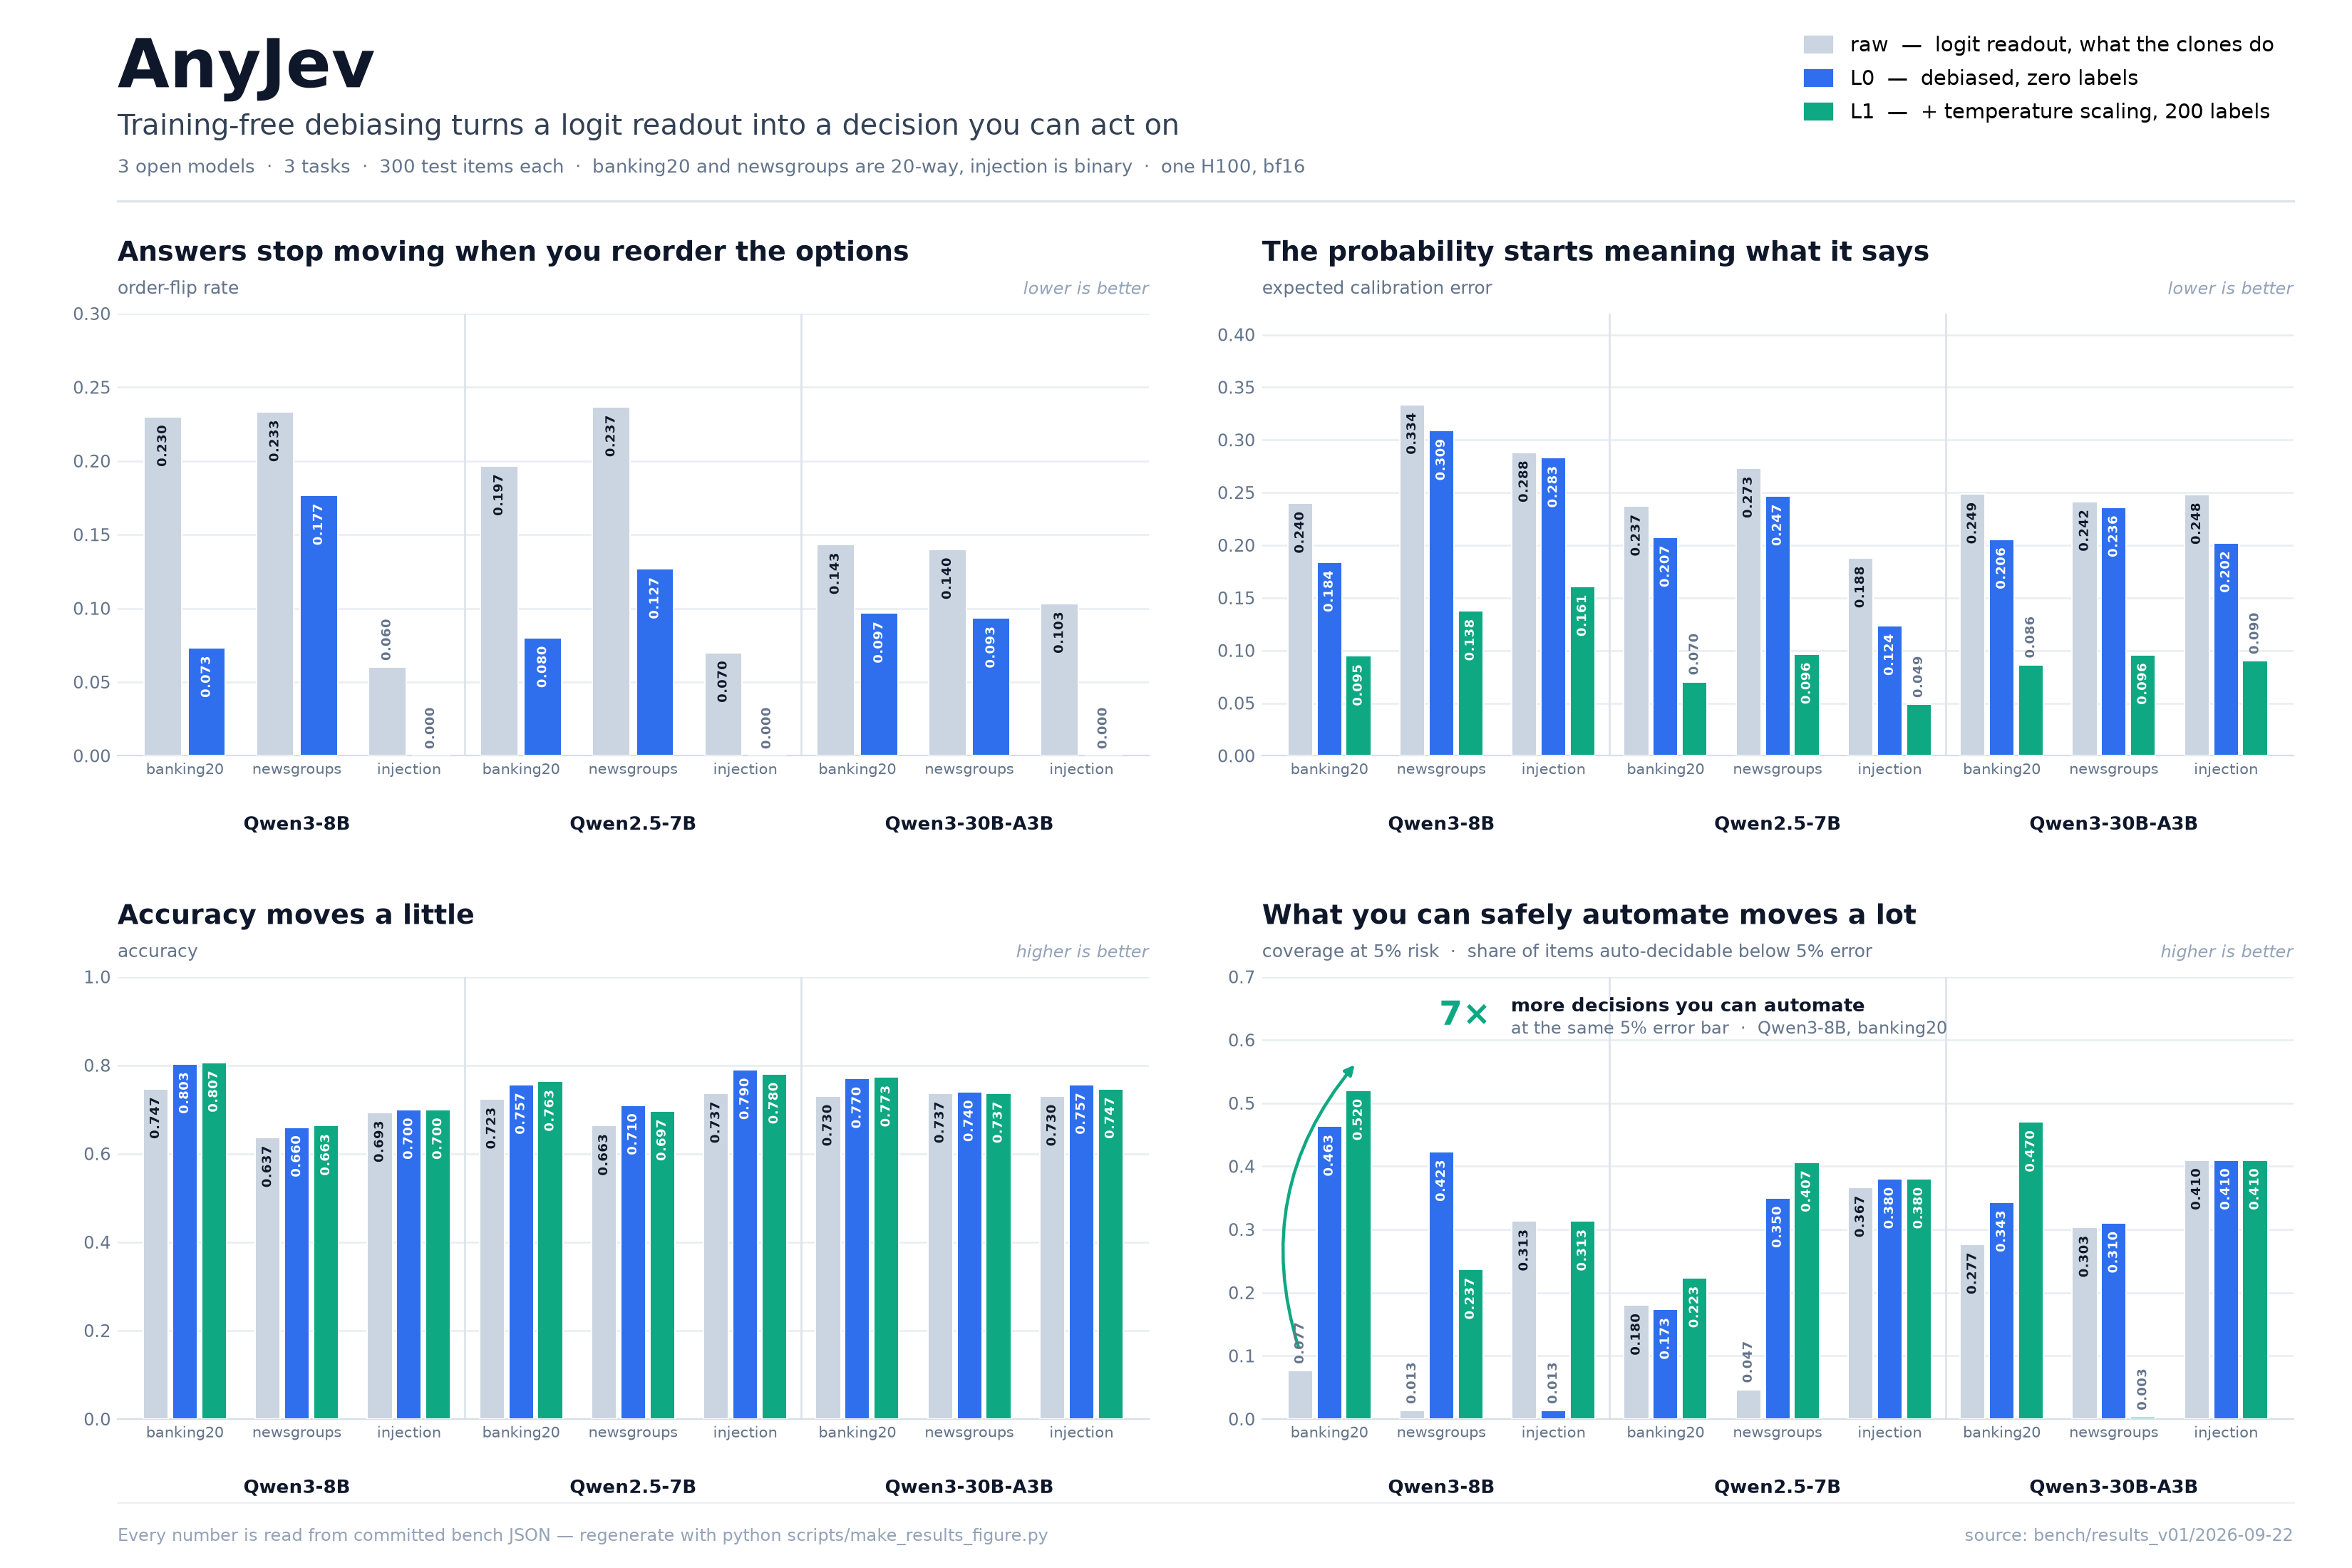
AnyJev 让开源 LLM 在仅使用前 2/3 层网络的情况下完成精确分类,每个问题用 100-300 条标注秒级训练专属 head。银行、客服等高频分类场景可大幅降低标注成本和推理开销。
Turn any LLM into a Jev-style decision model: typed decisions, real probabilities, no training. (continue updating)
媒体预览
编辑判断
之前做文本分类的团队要么全量微调大模型,要么用 prompt 工程硬套,成本高或效果差。AnyJev 的思路是把分类能力"前置"到模型浅层,用 closed-form 求解替代梯度下降,训练从小时级降到秒级。
跟 SetFit、AdaLoRA 这些少样本方案比,它不需要动模型主体参数,一个 prompt 挂多个轻量 head 就能服务不同业务线。Qwen3-8B 在 BANKING77 上的 demo 说明 8B 模型足够承载这个玩法。
适合两类人:一是用 GPT-4 API 做分类、每月烧掉几千美元的服务商;二是在端侧部署、 latency 敏感的金融/电信团队。注意它目前只验证了分类任务,生成任务能否迁移还不清楚。
Star History
生态分析
Experimental
Jev/System One赛道中专注「改造现有LLM」的轻量工具方案
独特价值:不训练全模型,仅加专属head让任意LLM秒变决策模型
竞品: