llama.cpp 底层张量库独立开源
推荐指数 69.0 NO. 004 · 2026.11.16
Stars15,884
简介
ggml 是 llama.cpp 背后的 C/C++ 张量计算库,主打零依赖、跨平台、支持从 CPU 到浏览器全后端。对需要在边缘设备或浏览器跑量化模型的团队,这是比 PyTorch 更轻量的基础设施选项。
Tensor library for machine learning
媒体预览
编辑判断
做端侧部署的团队之前多在 PyTorch Mobile 或 ONNX Runtime 之间二选一,但这两个方案在 2-4bit 极端量化和 WebAssembly 支持上都欠火候。ggml 的杀手锏是运行时零内存分配,这对嵌入式和浏览器场景意味着确定性延迟。
跟 TensorRT-LLM、vLLM 这些数据中心导向的方案不同,ggml 的竞品其实是 Google 的 XNNPACK 和微软的 ONNX Runtime Mobile——后两者 ARM NEON 优化不错,但 RISC-V 和 LoongArch 支持几乎空白。如果你的目标硬件是国产芯片或 MCU 级设备,ggml 几乎是唯一选。
已经在用 llama.cpp 的团队其实已经在间接用 ggml,但这次独立出来意味着可以剥离 llama 的耦合,直接接入自定义模型架构。做端侧小模型创业或需要将推理能力嵌入硬件固件的工程师,值得花一天时间把 ggml 的后端抽象层读一遍。
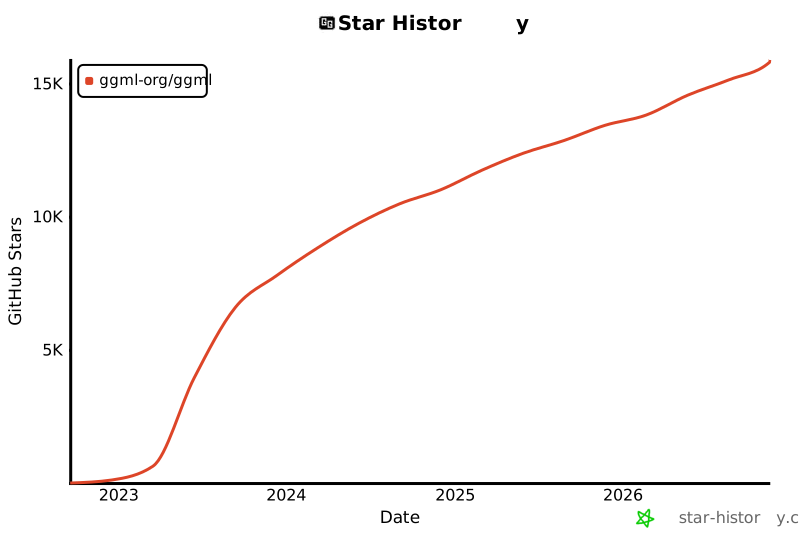
Star History
生态分析
Production
边缘AI推理的轻量级张量计算基础设施,llama.cpp的核心依赖
独特价值:零依赖、跨平台、支持CPU到浏览器全后端,极致轻量
竞品: