机器人实时控制突破19秒上下文
推荐指数 64.0 NO. 026 · 2026.10.09
upvotes88comments1
为什么值得看
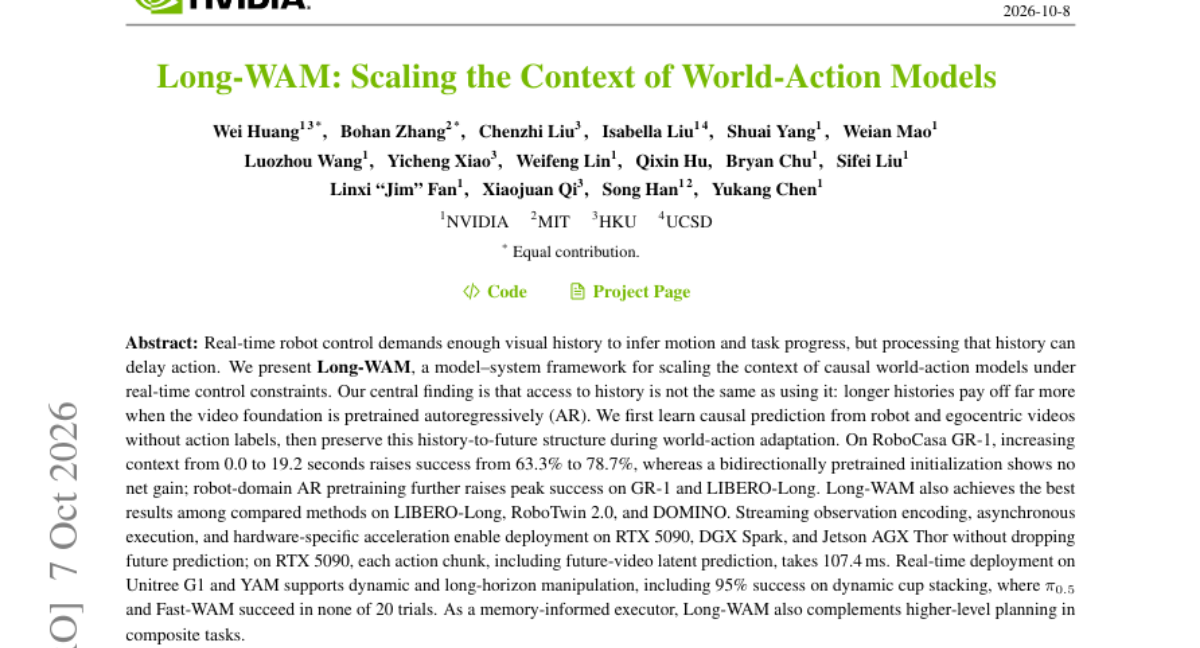
Long-WAM 提出了一种在实时控制约束下扩展世界-动作模型上下文长度的框架,核心发现是自回归预训练的视频基础模型才能真正利用长历史信息。在 RoboCasa GR-1 上将上下文从 0 扩展到 19.2 秒,成功率从 63.3% 提升至 78.7%,而双向预训练模型无增益。
媒体预览
编辑判断
机器人领域之前处理长上下文主要靠帧采样或关键帧提取,本质是在丢信息换速度。这篇的洞察很反直觉:不是历史长度的问题,是模型怎么'看'历史的问题——自回归预训练让模型形成了因果推理的 inductive bias,双向模型即使给了长上下文也用不起来。
这对做具身智能的团队有直接启发:如果你在用 ViT 或 MAE 做视觉 backbone 训机器人策略,可能需要重新考虑预训练方式。论文没有明确说是否开源代码,但方法本身不依赖特殊算子,复现门槛不高。