微信开源统一视觉模型
推荐指数 81.0 NO. 021 · 2026.10.24
upvotes221comments1
简介
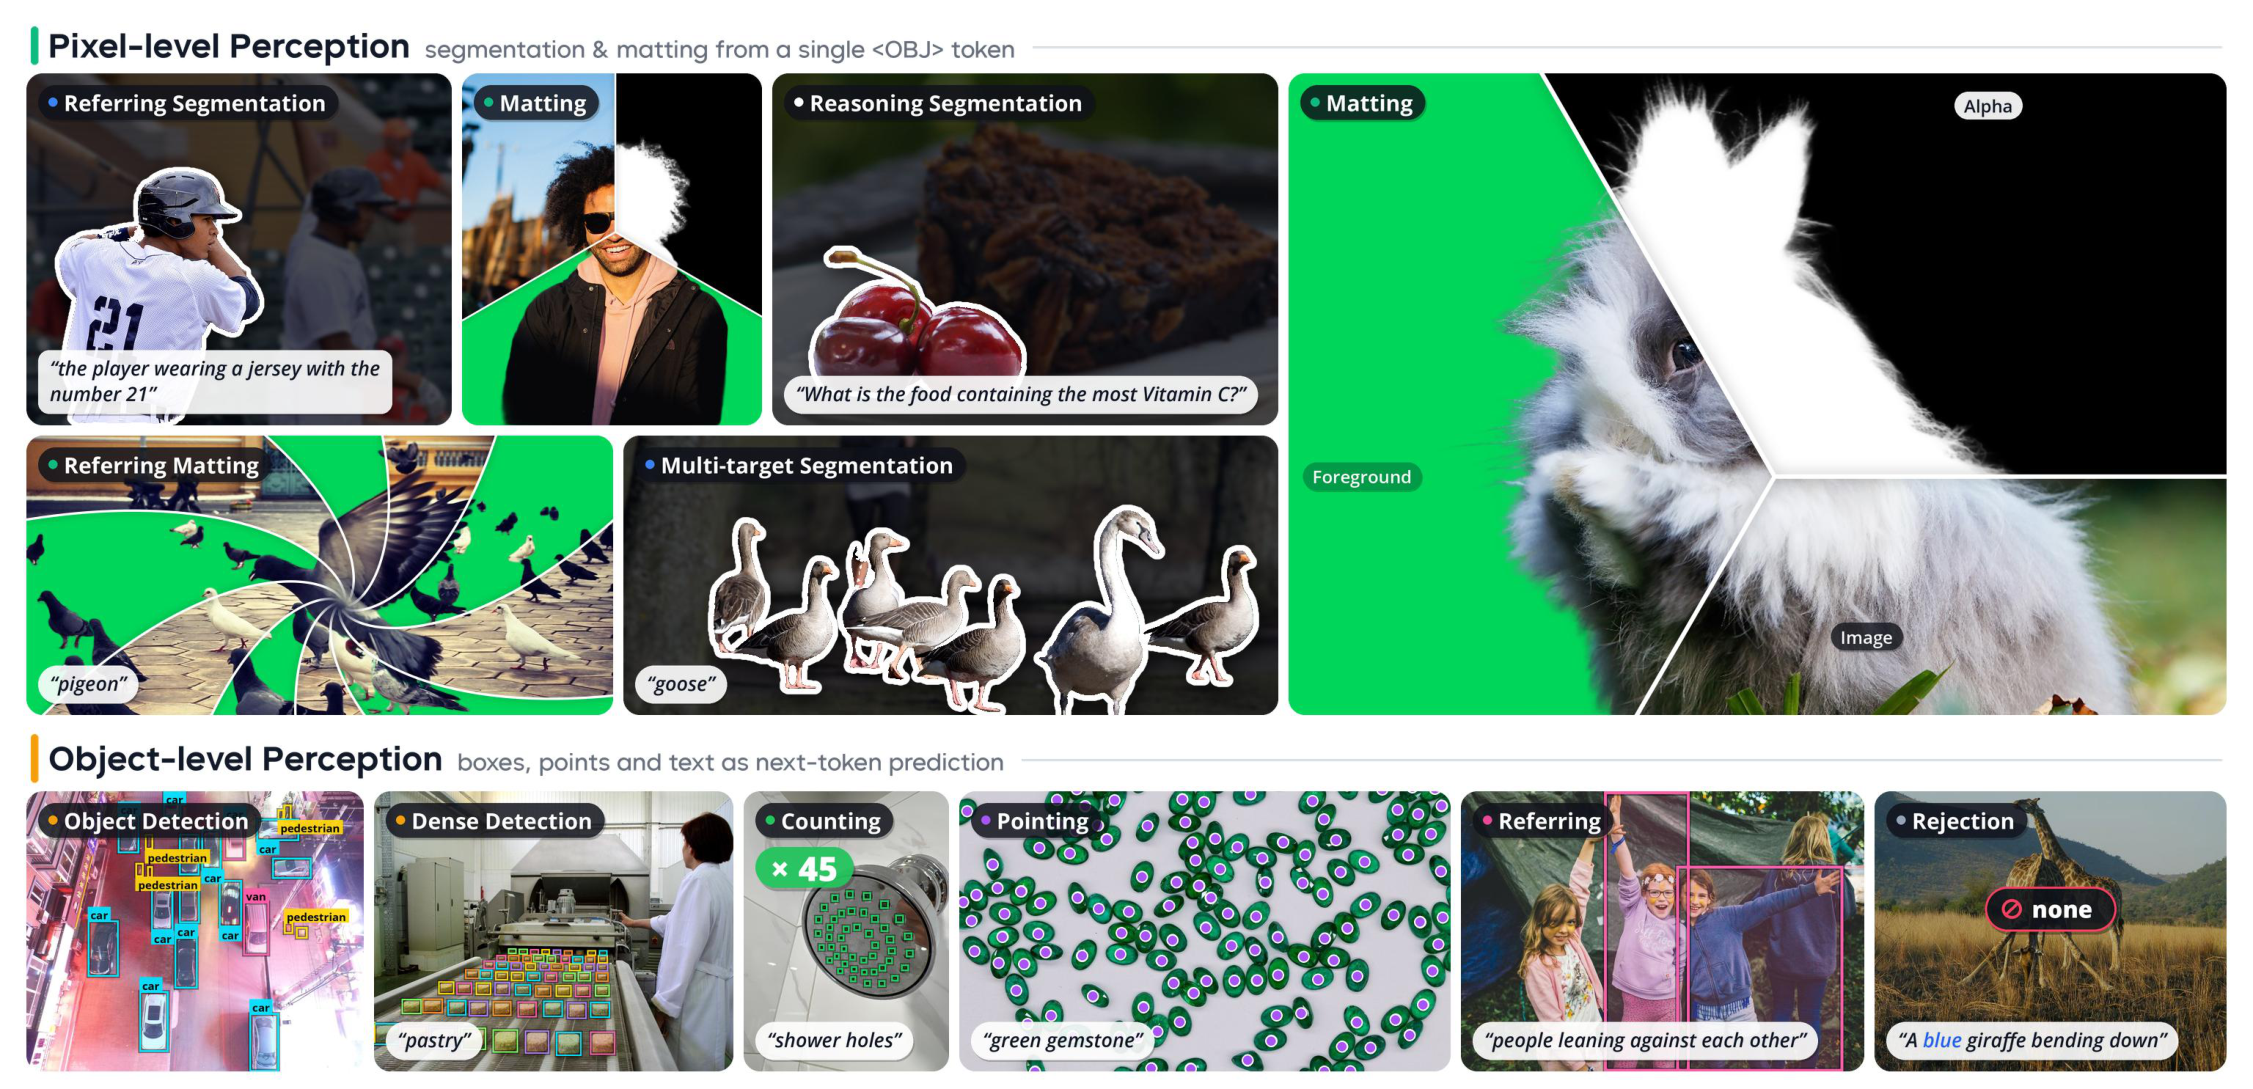
WeVisOne-VL 用结构化 token 预测统一了目标检测、分割、OCR、抠图等 6 类视觉任务,支持从像素到物体的任意粒度定位。对做多模态应用的工程师来说,这意味着不用再为不同感知任务堆叠多个专用模型。
媒体预览
编辑判断
当前视觉任务碎片化严重,检测用 DETR、分割用 SAM、OCR 用 PaddleOCR,管线复杂且模型冗余。WeVisOne-VL 的 trick 在于把像素解码器做得极轻量,靠多阶段训练让同一个 LLM backbone 同时输出 box、mask、alpha matte 等不同格式的结构化结果。
相比 Qwen2.5-VL 或 InternVL 这些通用多模态模型,它在细粒度定位任务上的统一性是差异化卖点,但 221 upvotes 仅 1 条评论说明社区还在观望实际效果。论文提到已开源,建议直接跑它跟 SAM 2 + GPT-4o 的组合在自家场景上的 latency 和精度对比,如果像素解码器确实够轻,端侧部署会是最大落地场景。