AI评测基准的搜索引擎来了
推荐指数 61.0 NO. 024 · 2026.09.15
upvotes75comments8
为什么值得看
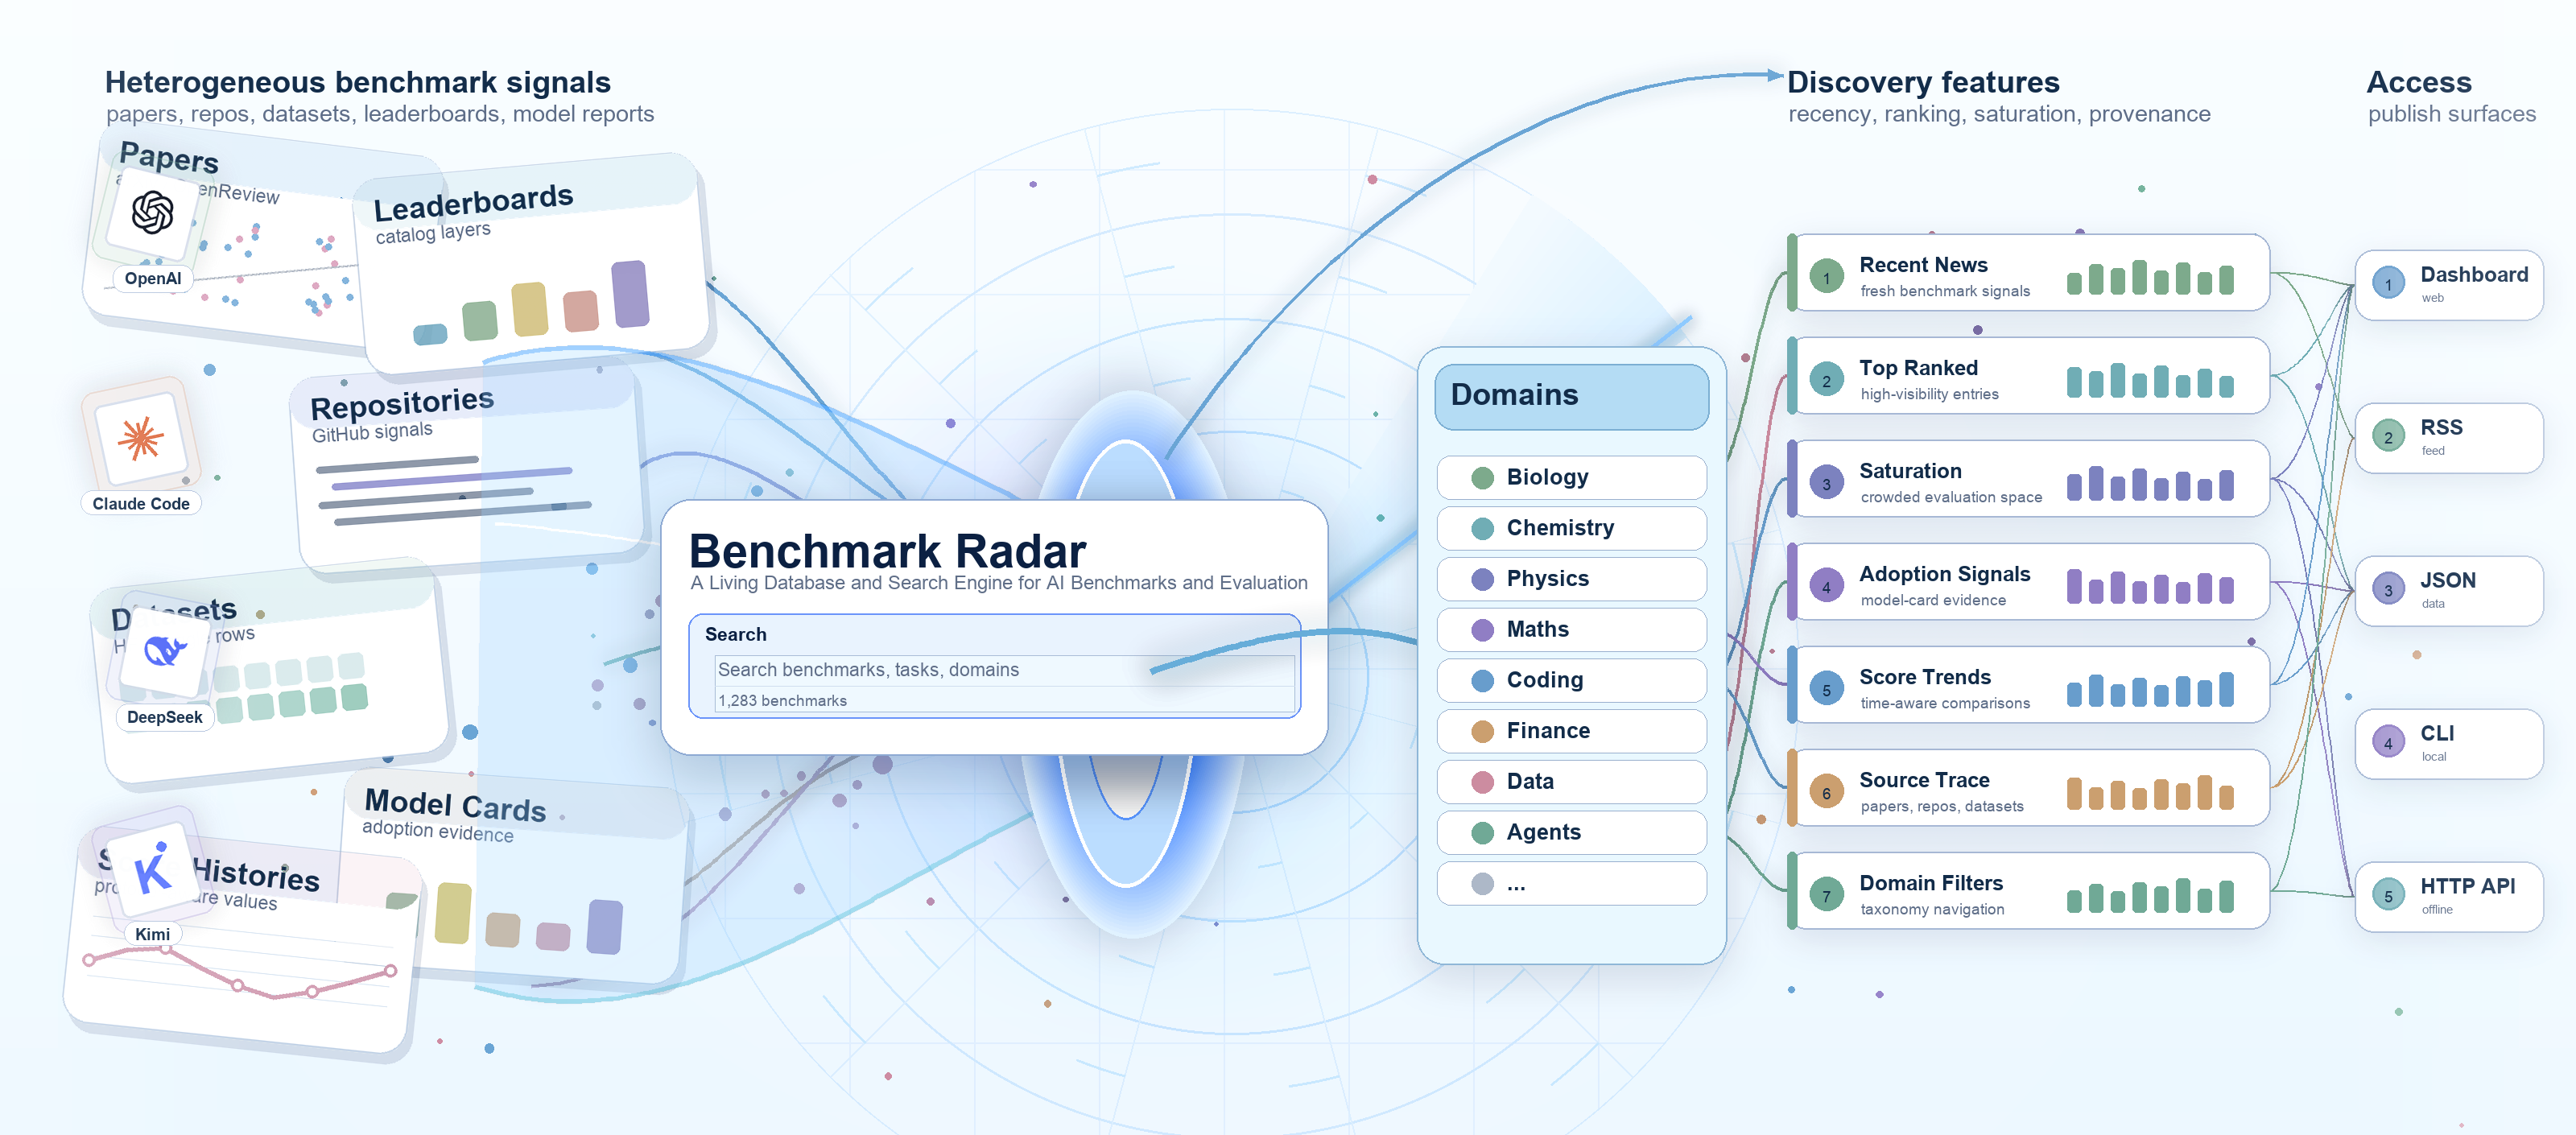
Benchmark Radar 是一个可检索的 AI 评测基准动态数据库,自动聚合论文来源、分数历史和使用证据。解决 LLM 研究者找评测基准时信息分散、版本混乱的痛点,做模型选型的团队能省大量调研时间。
媒体预览
编辑判断
做 LLM 评测的团队现在基本靠手动维护 Google Sheet 或 Notion 来追踪各个 benchmark,PaperWithCode 虽然全但更新滞后且缺少版本追溯。Benchmark Radar 的差异化在于"living"——自动抓取 arXiv 新论文并关联历史分数曲线,这比静态的 Papers With Code 数据集页面更贴近实际选型场景。
目前覆盖范围以 NLP/LLM 为主,多模态和语音评测还较薄弱。如果你团队正在做模型发布前的评测矩阵设计,建议直接用它替代手动调研,但复杂的企业内部评测仍需自定义补充。