TileLang:用Python写高性能GPU核函数
推荐指数 64.0 NO. 005 · 2026.10.02
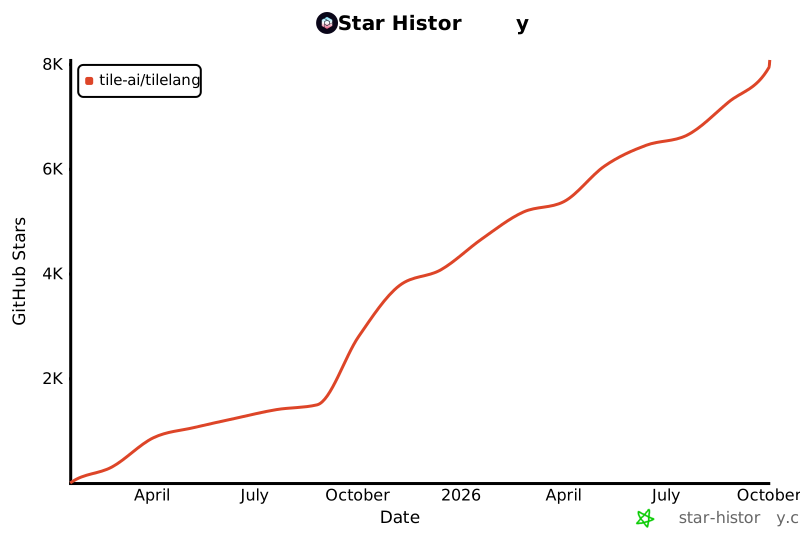
Stars8,079
为什么值得看
TileLang 是基于 TVM 的 Python DSL,让开发者用接近 Python 的语法编写 GEMM、FlashAttention 等高性能 GPU/CPU/NPU 内核,无需手写 CUDA。对需要定制算子但不想深入底层优化的 AI 团队,这是 Triton 之外的新选择。
Domain-specific language designed to streamline the development of high-performance GPU/CPU/Accelerators kernels
媒体预览
编辑判断
算子优化赛道长期被 Triton 垄断,但 Triton 的学习曲线和调试体验一直是痛点。TileLang 选择站在 TVM 肩膀上而非从头造轮子,这意味着它能直接继承 TVM 的多后端能力(ARM、AMD、NPU),这是 Triton 目前覆盖不足的。
已有团队用它把自定义 Dequant GEMM 做到接近 cuBLAS 性能,而代码量只有 CUDA 的 1/5。如果你在训推一体场景里总被"Triton 不支持这个后端"卡住,或者受够了 Triton 的编译错误信息,TileLang 值得作为备选方案跑一轮 benchmark。
短期风险是生态成熟度:Triton 有 PyTorch 2.0 原生集成和大量社区算子库,TileLang 目前主要靠官方 examples,社区贡献者规模还很小。
Star History
生态分析
Beta
TVM 生态中的 Pythonic 算子开发 DSL,定位 Triton 替代方案
独特价值:基于成熟 TVM 后端,降低自定义高性能算子开发门槛
竞品: