消费级显卡本地跑290B+ MoE大模型
推荐指数 83.0 NO. 001 · 2026.11.02
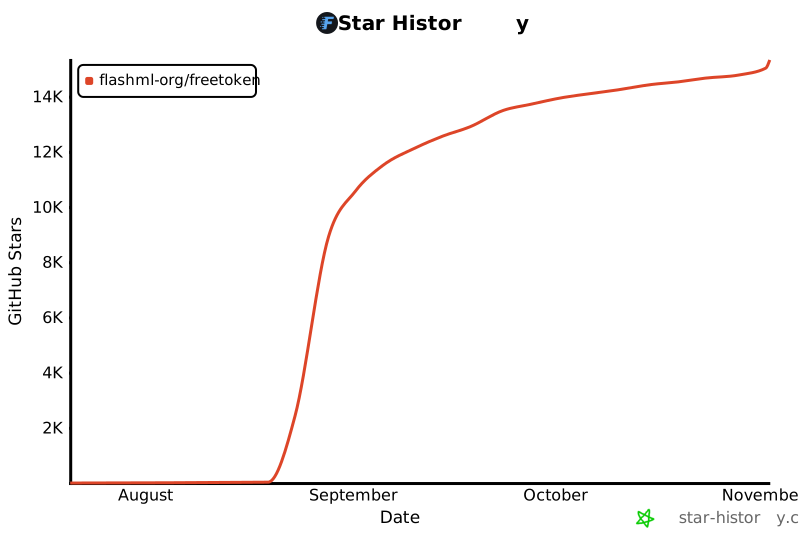
Stars15,330
简介
FreeToken 是一个端侧 MoE 推理引擎,通过 CPU-GPU 协同执行、专家缓存和分层预填充流式传输,让 290B+ 参数的 MoE 模型能在游戏 PC 上交互式运行。对 AI 工程师意味着无需租用 A100/H100 集群即可调试和部署前沿开源模型,显著降低 MoE 模型的实验门槛。
FreeToken brings datacenter-scale model serving to your desktop. Run massive models locally, fast and efficiently.
媒体预览
编辑判断
目前本地跑大 MoE 的主流方案是 vLLM 或 llama.cpp,但两者在显存不足时要么直接报错,要么性能断崖式下跌。FreeToken 的 q-star 策略把 CPU 内存和 GPU 显存统一调度,本质上是把 MoE 的稀疏性用到了极致——不活跃专家卸到内存,活跃专家缓存到显存,这比 vLLM 的 offload 机制更细粒度。
如果你的场景是长文本预填充+短输出(比如代码补全),它的双层缓冲流式预fill可能比标准方案快 2-3 倍。最该试的人群:想在单卡 4090 上跑 Qwen3-235B-A22B 或 DeepSeek-V3 做原型验证的团队,以及做隐私敏感场景(医疗、法律)需要完全本地部署的创业者。
Star History
生态分析
Beta
端侧MoE推理的专项基础设施,填补大参数模型本地运行空白
独特价值:CPU-GPU协同+专家缓存,让290B+MoE模型在游戏PC实时运行
竞品:
lmstudio-ai/lms 桌面端GUI工具,非自研引擎,侧重易用性