LLM免解码生成结构化决策
LLM2Jev 通过预填充(prefill)机制让本地模型直接输出结构化决策结果,跳过逐 token 解码环节,支持文本和图像多模态输入。对需要低延迟、确定性输出的 AI 工程场景(如游戏 NPC、实时交易决策)有直接价值。
Adapt local language models into Jev-compatible structured decision engines with Choice, Score, and Noul outputs powered by prefill-only binary inference.
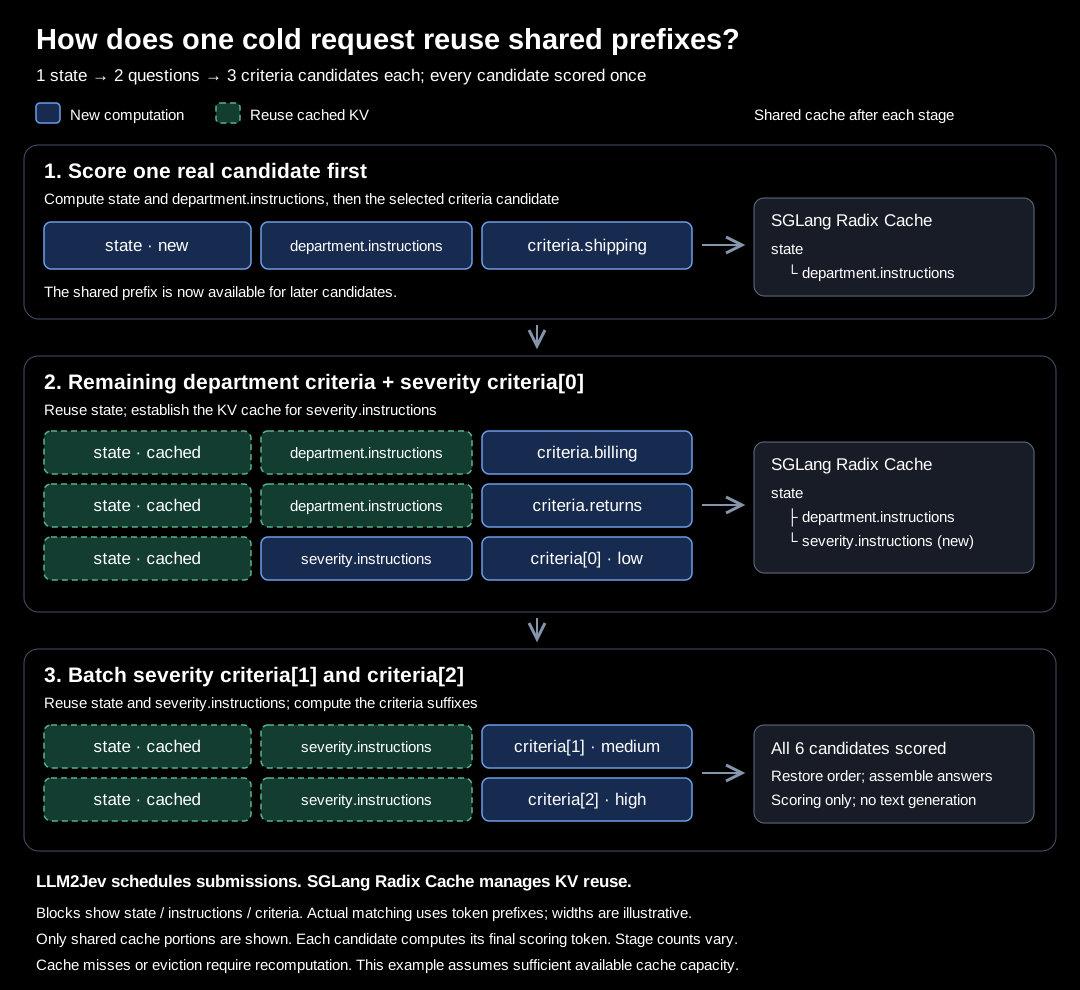
目前主流的结构化生成方案如 Outlines、Guidance 或 vLLM 的 guided decoding,都是在解码阶段用 FSM 或语法约束逐 token 过滤,延迟开销明显。LLM2Jev 的反直觉思路是把"决策"直接编码进预填充的 KV Cache 里,让模型在 prefill 阶段就"算完"结果,decode 阶段几乎为零。
这个做法和 SGLang 的 Radix Cache 结合很巧妙——冷请求通过 staged candidate submission 复用 prefix,本质上是用内存换延迟。但限制也明显:决策空间必须是有限且预定义的,不适合开放式生成。如果你的场景是游戏 AI、规则引擎或配置下发这类"有限选择"问题,比用 JSON mode 或 function calling 快一个数量级。
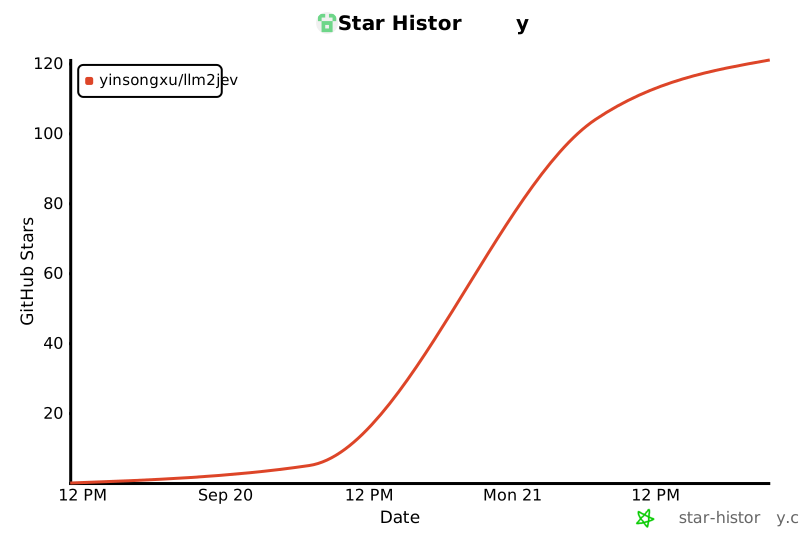
项目刚 121 star,但作者在多模态和 demo 上迭代很快,建议关注它能否扩展到更复杂的嵌套决策结构。
首个专注预填充结构化决策输出的本地LLM推理框架,填补低延迟确定性AI工程工具空白。
独特价值:以prefill-only跳过token解码,实现多模态输入的确定性结构化输出,极致降低延迟。