NVIDIA 开源企业数据语义层
Auto Ontology 从企业元数据自动生成统一的数据本体,通过 MCP/API/CLI 暴露给任意 Agent 使用,解决多系统数据定义冲突和 Agent 用错数据的可靠性问题。做企业 Agent 落地的团队可以直接接入现有语义模型,不用从零重建数据治理层。
Auto Ontology is a Python framework for building semantic, graph-based reasoning layers over data. It enables deterministic query generation, better context retrieval, and more explainable AI for LLM and agent workflows.
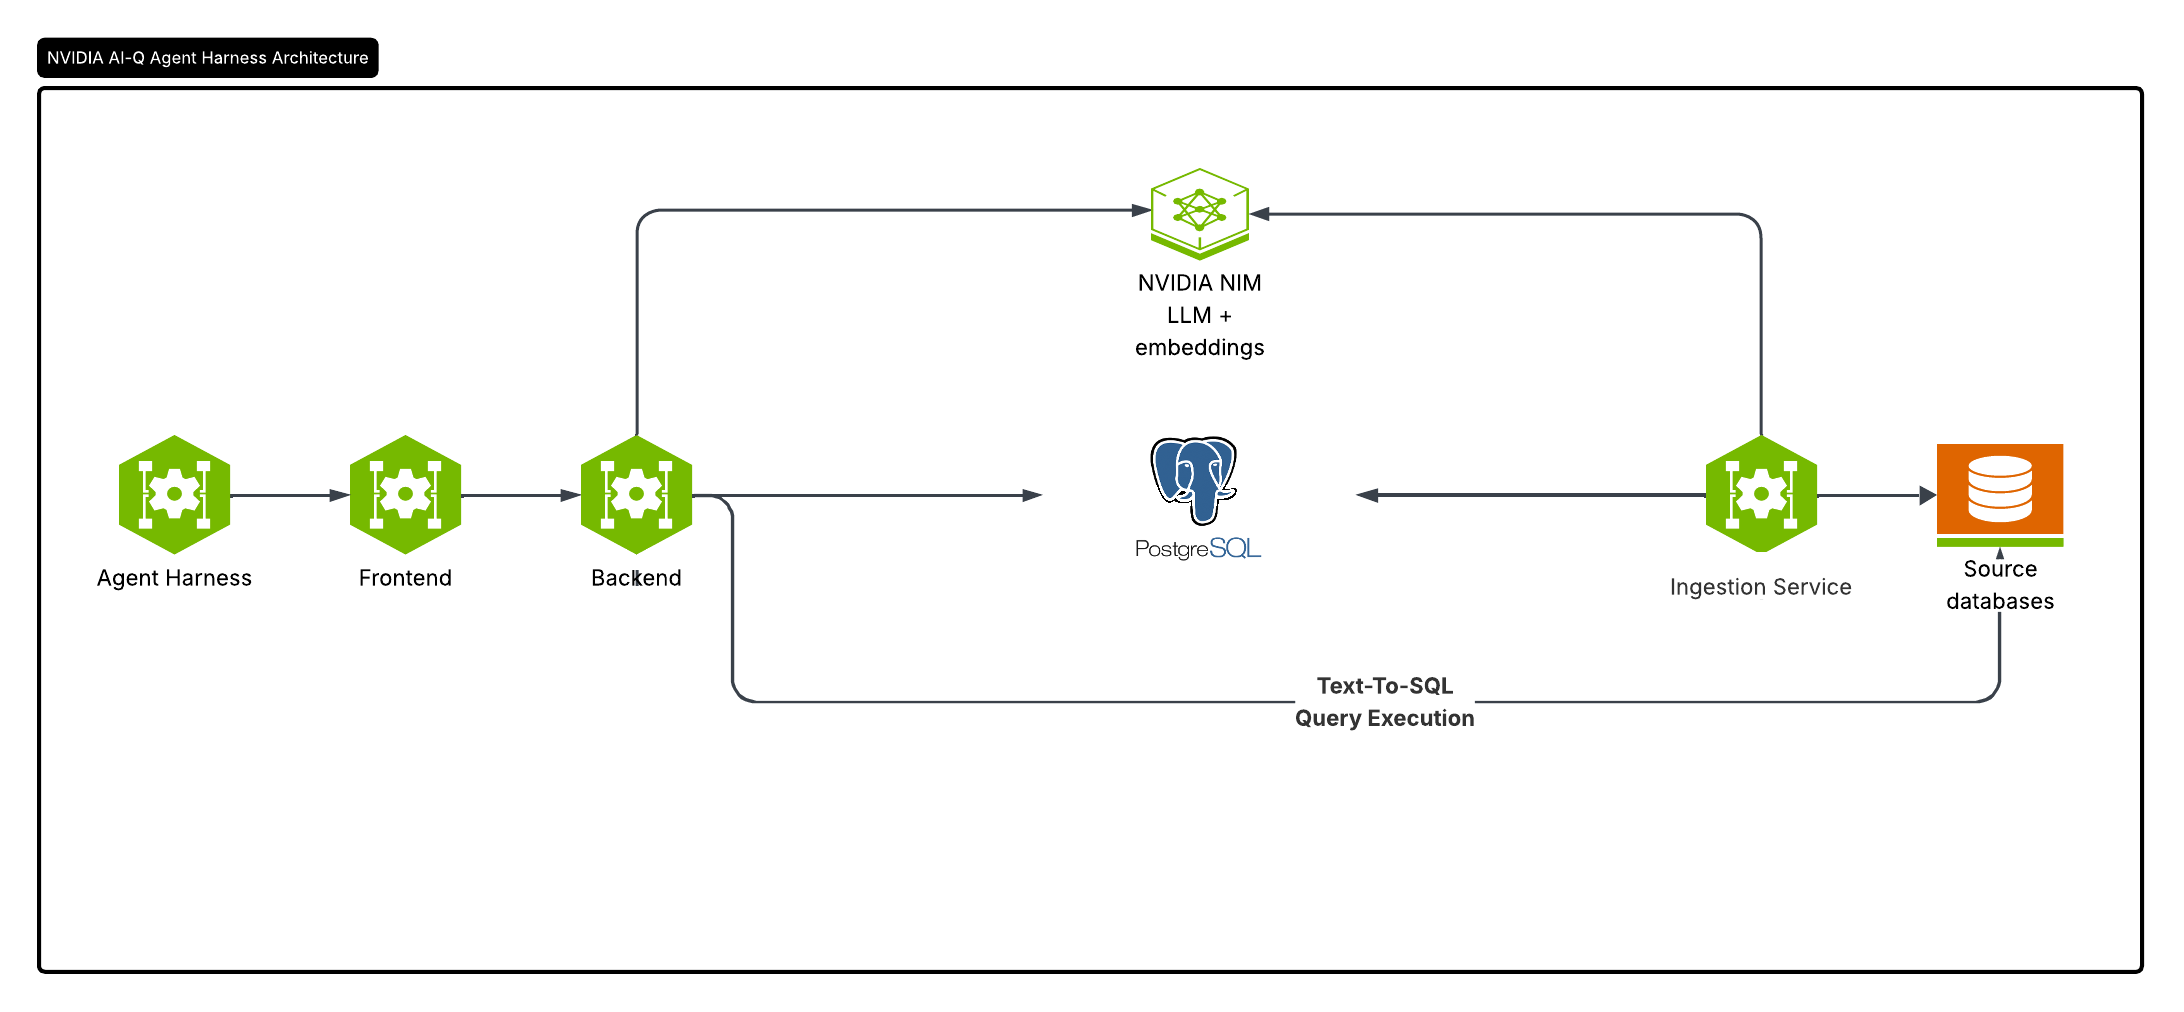
企业 Agent 落地最大的隐性成本不是模型调用,而是让 Agent 理解「这张表的 revenue 是否包含退款」这类业务语义。之前团队要么硬编码规则到 prompt,要么在 LangChain 里自己封装业务上下文层,维护成本极高。
Auto Ontology 的关键设计是「兼容现有语义模型」而非替换,这直接对标了 dbt Semantic Layer、Cube 这类已有投资,降低了企业采纳门槛。跟 Palantir Ontology 的封闭生态相比,开源 + MCP 标准接口让它更容易嵌入现有 Agent 架构。
如果你正在用 LlamaIndex 或 CrewAI 做企业内部 Agent,且数据源超过 3 个异构系统,建议优先评估这个项目的数据血缘和定义调和能力,这比换更大的模型更能降低幻觉风险。
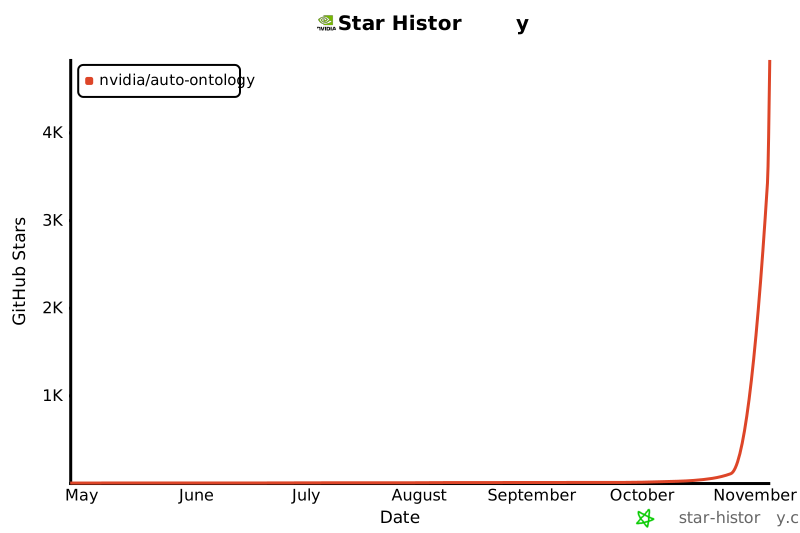
企业Agent落地的数据语义中间层,连接异构系统与LLM推理
独特价值:从现有元数据自动生成本体,零重建接入企业数据治理