反向利用LLM审稿偏好优化论文
推荐指数 42.0 NO. 012 · 2026.09.24
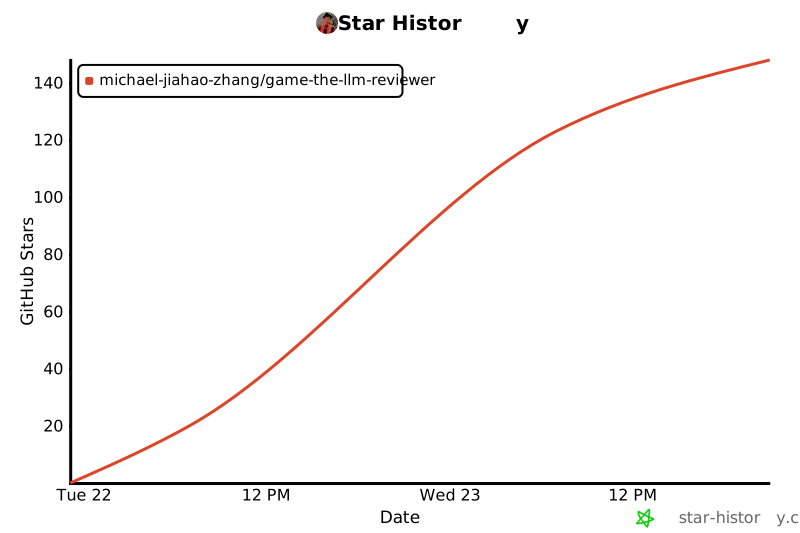
Stars148创建1 天前Forks4Issues0
为什么值得看
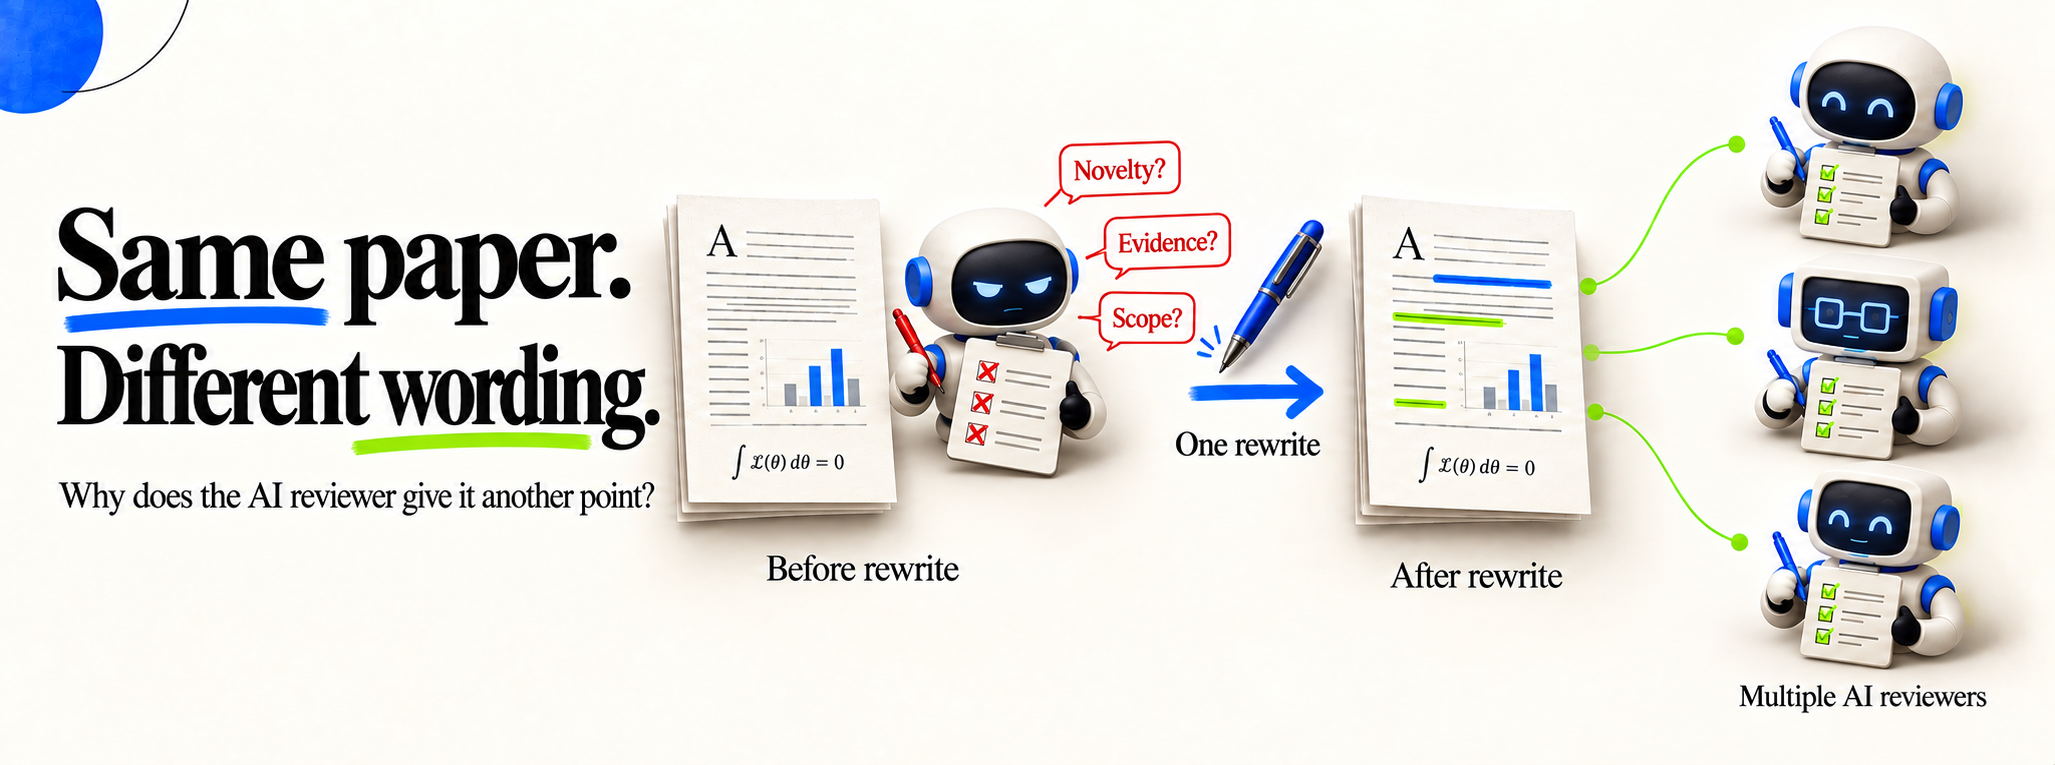
该项目将LLM审稿偏好研究转化为可复用的agent skill,在保持科学原意的前提下微调措辞以通过LLM审稿。对被迫面对LLM审稿的学术作者来说,这是务实的防御性工具。
Defend sound research against LLM reviewer bias through meaning-preserving rewrites.
媒体预览
编辑判断
学术界对LLM审稿的焦虑已经持续了两年,但大多数应对策略停留在"呼吁禁止"或"检测LLM痕迹"的被动层面。这个项目的聪明之处在于承认 LLM 审稿不可阻挡,转而用对抗性思维优化文本——本质上是用魔法打败魔法。
与 Grammarly、PaperPal 等传统润色工具不同,它不是追求语言正确性,而是针对特定 LLM 的评分模式做策略性调整。目前 148 stars 说明这个痛点很真实,但策略库还比较小,如果作者持续补充不同模型(Claude、Gemini、国产模型)的偏好数据,价值会大幅提升。
正在投稿顶会、且目标会议/期刊已知使用 LLM 辅助审稿的团队,建议直接集成到 arXiv 提交前的 pipeline 里,作为最后一道自动检查。
Star History
生态分析
Experimental
学术写作agent技能库中的LLM审稿对抗防御工具
独特价值:首个将LLM审稿偏见研究转化为可复用对抗技能的防御性工具
竞品: