4B/9B模型自迭代训练闭环原型
推荐指数 64.0 NO. 005 · 2026.09.11
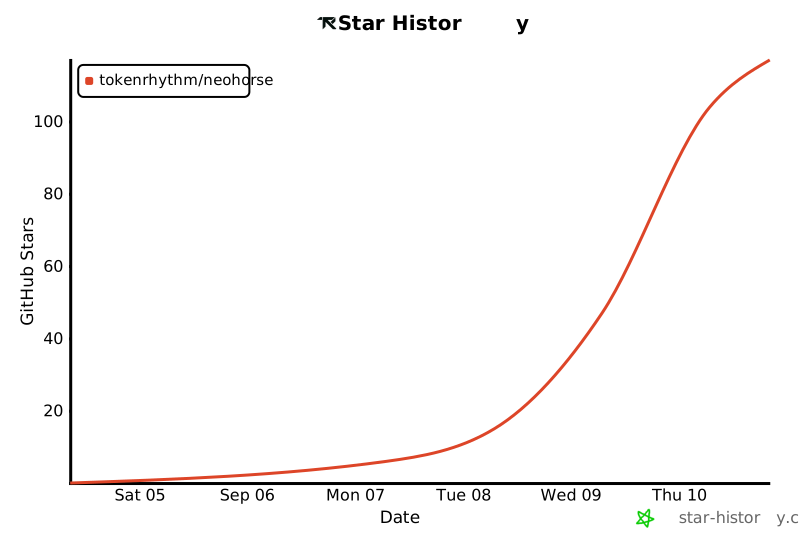
Stars117创建6 天前Forks3Issues0
为什么值得看
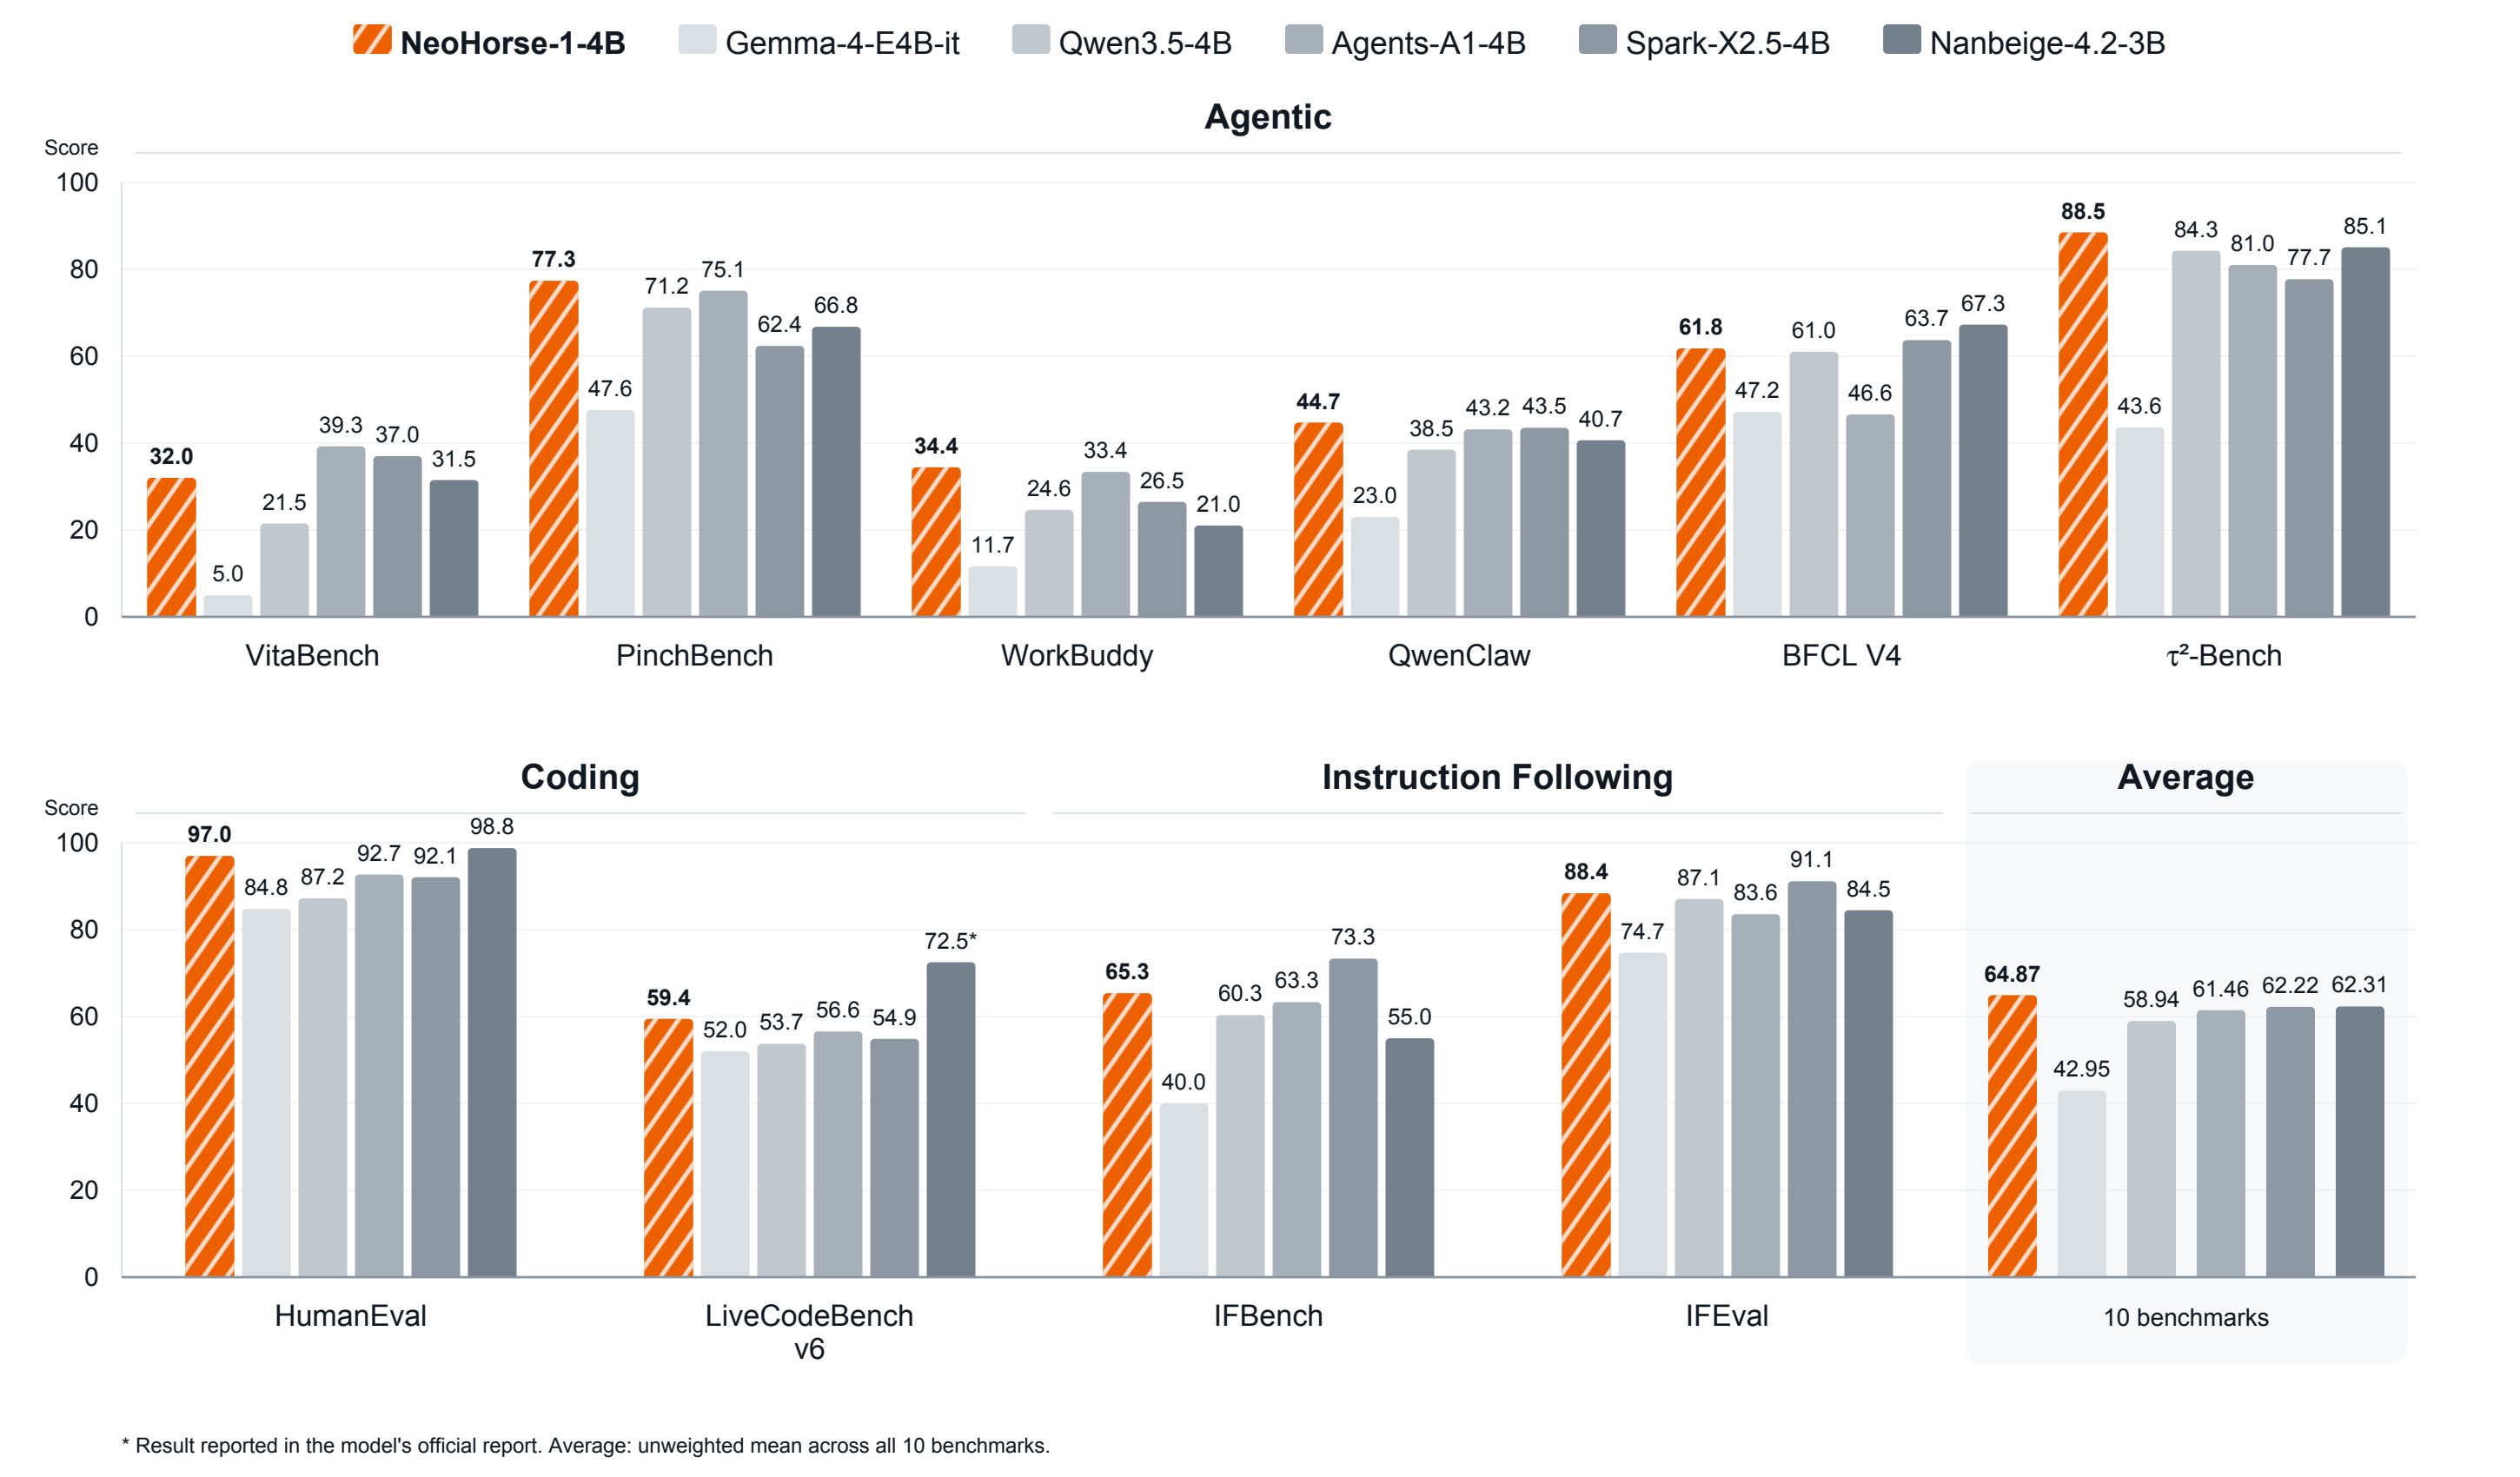
NeoHorse-1基于Qwen3.5后训练,构建了一个评估-选择-更新的路由 harness,让模型能在异构模型池中分配任务、记录交互结果,并将能力反馈注入下一轮训练混合。这是少数把RSI从概念推进到可运行原型的尝试,对研究模型自我进化边界的团队有直接参考价值。
NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness.
媒体预览
编辑判断
RSI领域之前大多是理论探讨,比如OpenAI的Superalignment团队和Anthropic的RLHF扩展研究,但公开可运行的原型极少。NeoHorse-1的务实之处在于它没有从头训基础模型,而是把后训练环节做成闭环,用路由harness把能力需求显式量化,这降低了实验门槛。
跟Constitutional AI或RLAIF相比,它的差异化是任务级别的能力估计和动态训练混合,而不是静态规则或偏好模型。不过目前只有117 stars且零issue,说明代码成熟度和社区验证都还在早期。
如果你在做agent训练管线或研究模型能力涌现的测量方法,这个harness的设计思路比模型权重更值得细看,建议关注它下一轮迭代是否真的能形成跨代际的RSI循环。
Star History
生态分析
Experimental
RSI领域早期可运行原型,聚焦Agent后训练与模型自我进化边界探索
独特价值:将递归自改进从概念落地为Qwen后训练+路由harness的可运行系统
竞品: