vLLM 推理吞吐量再破天花板
推荐指数 52.0 NO. 009 · 2026.10.21
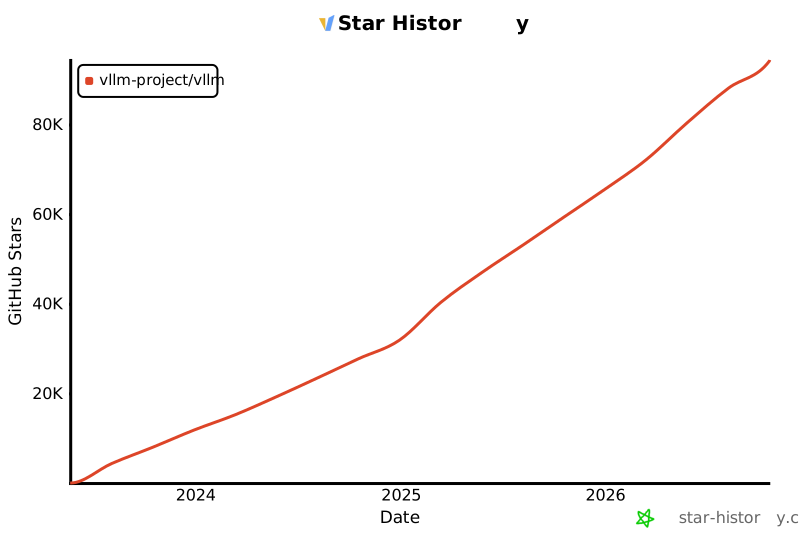
Stars94,395
简介
vLLM 是伯克利 Sky Computing Lab 发起的开源 LLM 推理服务框架,以 PagedAttention 技术实现业界领先的 serving 吞吐量。对需要自托管大模型的团队来说,它是降低 GPU 成本、提升并发能力的默认选型之一。
A high-throughput and memory-efficient inference and serving engine for LLMs
媒体预览
编辑判断
做 LLM 自托管的团队之前大多用 HuggingFace TGI 或 TensorRT-LLM,但 TGI 的内存碎片化严重,TensorRT-LLM 的编译和模型适配成本太高。vLLM 的 PagedAttention 把 KV cache 按块管理,让 GPU 利用率从 40-50% 拉到 80% 以上,而且支持动态 batching 和 speculative decoding,生态上现在连 AWS SageMaker、Azure 都原生集成。
如果你现在的推理服务还在用 naive 的 HF pipeline,或者 TensorRT-LLM 的编译让你头疼,vLLM 是迁移成本最低、收益最明确的选项。需要多卡并行或跨节点部署的话,它最新的 v1 架构把调度开销也大幅降了,值得优先测试。
Star History
生态分析
Production
LLM推理服务基础设施核心引擎,开源社区事实标准
独特价值:PagedAttention技术实现高吞吐低显存,多硬件生态支持最广