PPO 价值函数崩溃的根因与修复
推荐指数 64.0 NO. 021 · 2026.09.18
upvotes60comments1
为什么值得看
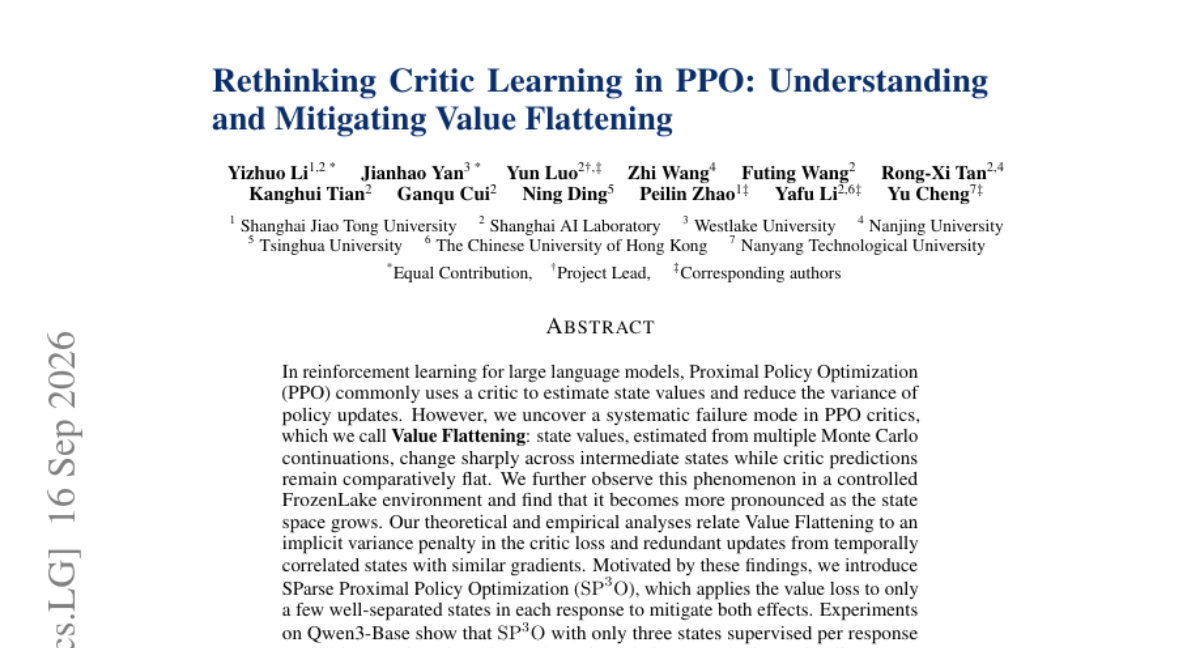
发现 PPO 中 critic 网络存在"Value Flattening"失效模式:真实状态价值剧烈变化,但 critic 预测趋于平坦。理论证明这与 critic loss 中的隐式方差惩罚有关,并在 FrozenLake 环境中验证了随状态空间扩大而加剧的规律。
媒体预览
编辑判断
做 RLHF 的工程师应该都遇到过 PPO 训练不稳定、reward hacking 或者模型"学不动"的情况,大家通常归因为 reward model 质量或 KL 散度调参。这篇论文指出的 Value Flattening 提供了一个被忽视的视角:critic 本身在系统性低估中间状态的价值波动,导致 policy gradient 的方差控制失效。
论文给出的修复方向是调整 critic loss 中的方差惩罚项,这比改网络架构或加更多数据便宜得多。如果后续有开源实现,建议在自己的 PPO 训练代码里对比验证,特别是状态空间大的长上下文任务。