扩散语言模型终于追上AR质量
推荐指数 71.0 NO. 019 · 2026.10.07
upvotes53comments1
为什么值得看
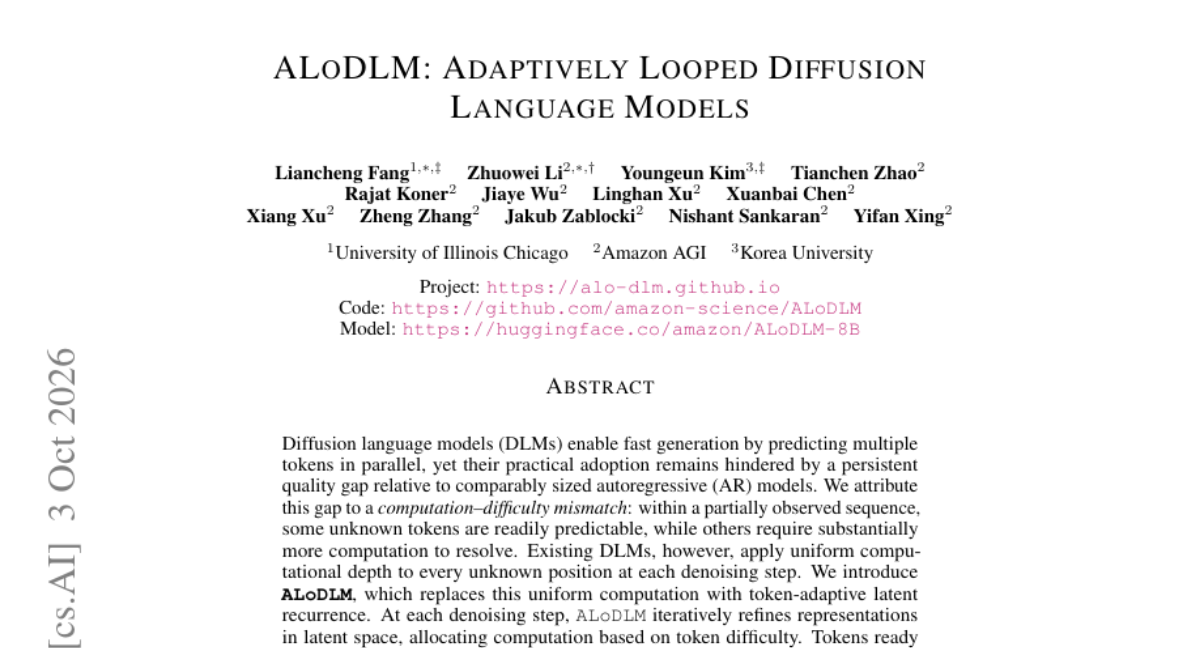
ALoDLM 让扩散语言模型根据 token 难度动态分配计算量,简单 token 早提交、困难 token 多迭代。这直接缩小了 DLMs 与自回归模型之间长期存在的质量差距,让并行生成在工程上更可用。
媒体预览
编辑判断
扩散模型做文本生成喊了两年多,核心瓶颈从来不是速度而是'该快的地方快不了,该慢的地方浪费算力'。之前 SSD-1B、Mercury 这些工作都在搞全局固定步数,ALoDLM 的 token 级自适应是更根本的解法。
从摘要看没有给具体数据集上的绝对数值提升,但思路对标了视觉领域 DeepMind 的 PonderNet 和 Google 的 AdaTape,这种 per-token dynamic depth 在 LLM 里还没跑通。
如果代码开源且能复现到 7B 规模,做实时交互场景(如代码补全、聊天)的团队应该优先试,并行生成的 latency 优势在 batch=1 时太明显了。