LLM生成策略冻结,Jev接管实时决策
JevHarness 让强 LLM 在开发阶段深度推理并生成任务专用的 harness 代码,冻结后由轻量的 Jev 引擎做低延迟决策,无需每次调用大模型。对需要高频决策的 AI 代理和机器人场景,这是降低延迟和成本的新范式。
LLM-authored task-specific Jev harnesses with optional full-trajectory reward reflection and GEPA evolution.
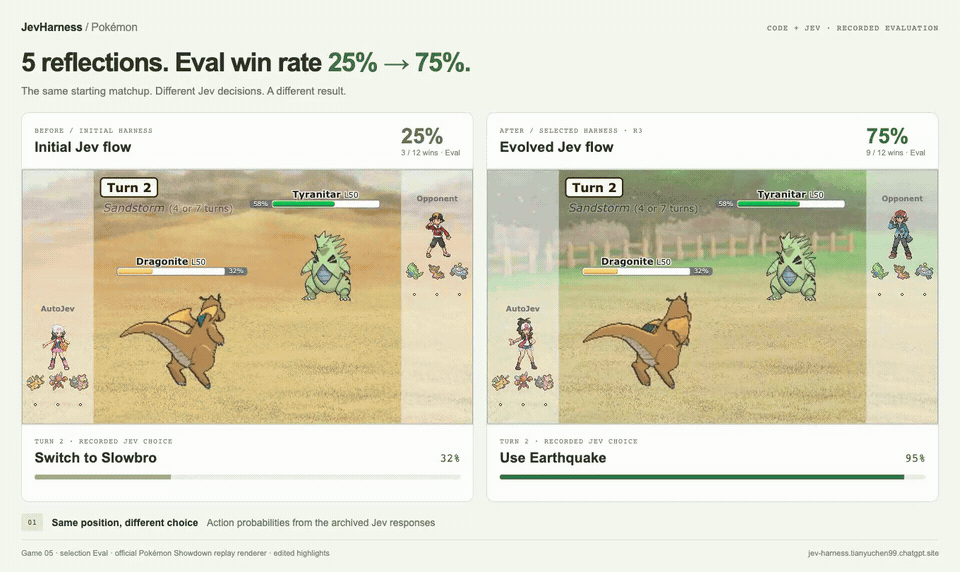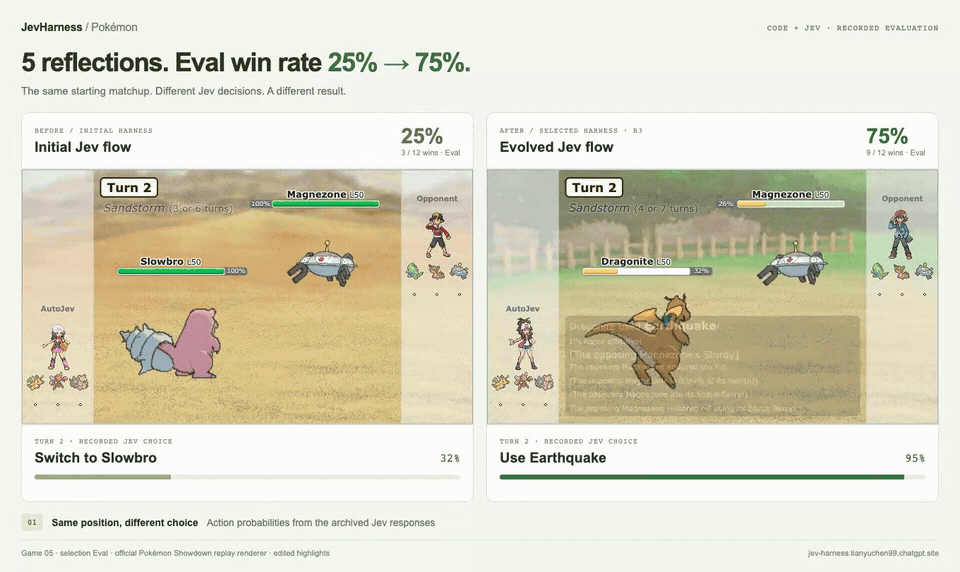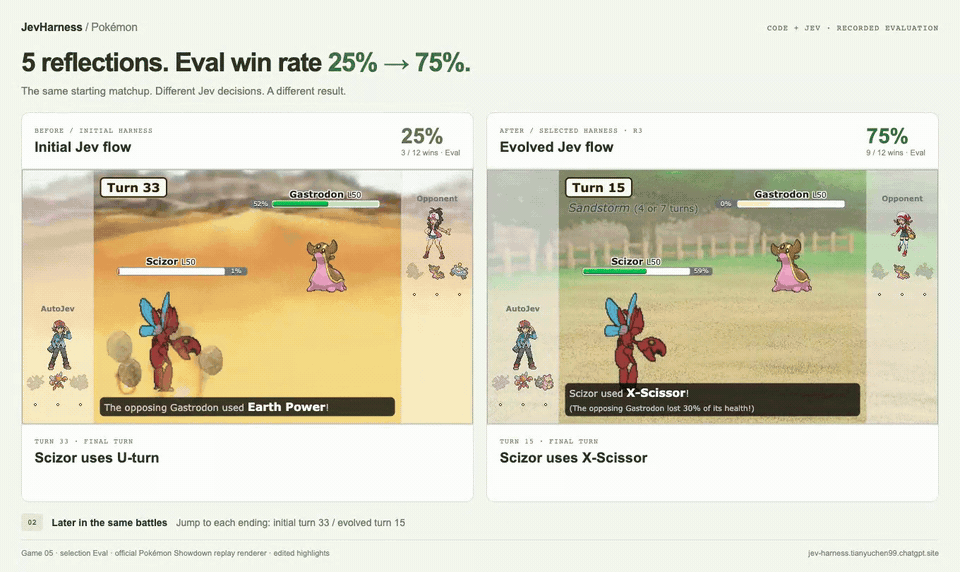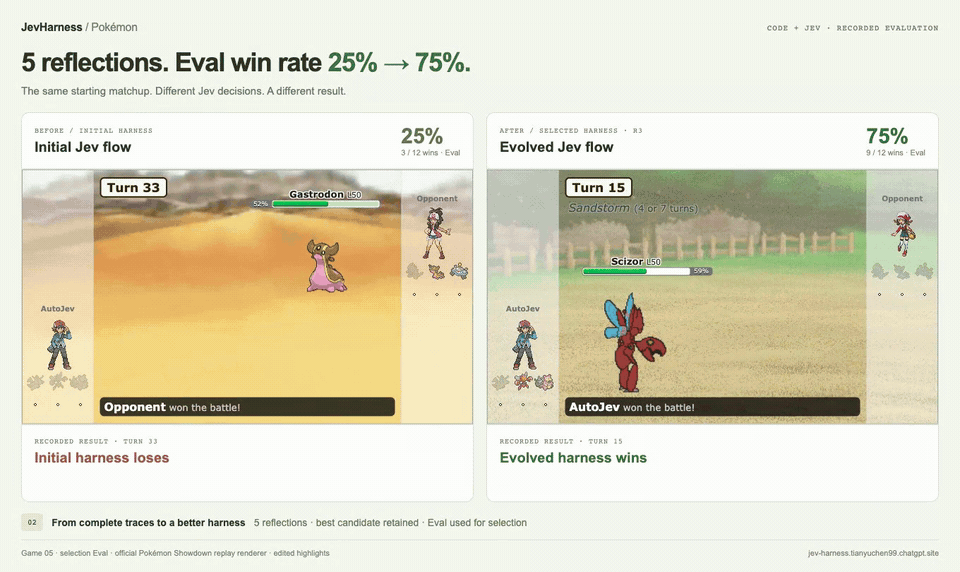
当前 AI 代理的主流架构是每次决策都走 ReAct 或类似循环,强 LLM 全程参与导致延迟居高不下。JevHarness 的思路接近"策略蒸馏"——把慢思考的结果编译成快执行代码,这和 Google 的 AlphaTensor 或 Berkeley 的 compiled neural network 有共通之处,但面向的是通用代理任务。
与 LangChain 或 AutoGPT 这类全程 LLM 驱动的框架不同,JevHarness 在运行时完全解耦了 authoring LLM,这意味着你可以用 GPT-4 或 Claude 写 harness,但部署时只跑一个轻量规则引擎。对于无人机、交易机器人等毫秒级决策场景,这种架构取舍很务实。
目前 140 stars 且零 issue,说明项目还很早期,但"推理时冻结策略"这个设计模式值得所有做实时 AI 系统的团队关注。如果你在搭的代理对延迟敏感,可以先看它的 harness 生成 prompt 设计,而不是直接上生产。
LLM生成专用harness+轻量引擎执行的新范式,聚焦高频决策场景的低延迟替代方案
独特价值:冻结LLM生成的harness代码,以轻量引擎替代每次大模型调用,显著降低延迟与成本