云原生监控事实标准再上榜
推荐指数 45.0 NO. 010 · 2026.11.07
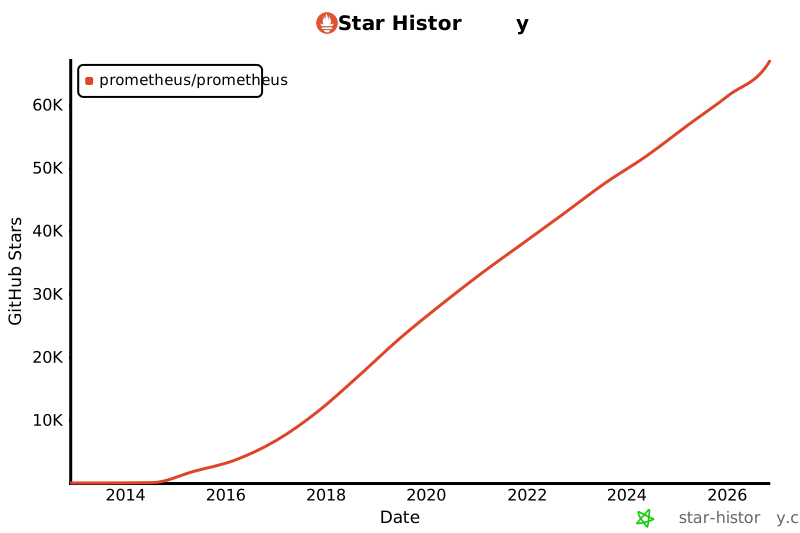
Stars67,146
简介
Prometheus 是 CNCF 毕业项目,用多维数据模型和 PromQL 做指标采集与告警。AI 系统的推理延迟、GPU 利用率、服务 SLO 都需要它兜底,运维基建绕不开。
The Prometheus monitoring system and time series database.
媒体预览
编辑判断
做 LLM 推理服务的团队现在面临一个新痛点:GPU 集群的指标爆炸。Prometheus 的单节点自治架构在千卡规模下容易成为瓶颈,业内不少团队已经转向 VictoriaMetrics 或 Thanos 做长期存储,但实时告警链路仍保留 Prometheus 原生。
如果你的 AI 服务还在用默认的 15s scrape interval,建议调到 5s 以下并开启 exemplar 追踪,推理长尾延迟的归因会清晰很多。另外 Grafana 刚把 Prometheus 查询语言集成到 LLM 可观测面板里,这套组合正在变成 MLOps 的事实标准。
Star History
生态分析
Production
云原生可观测性基石,CNCF毕业级指标监控与告警标准
独特价值:多维数据模型+PromQL成行业标准,AI运维与K8s生态事实标准
竞品: