LLM直接改权重修机器人策略
推荐指数 73.0 NO. 002 · 2026.11.15
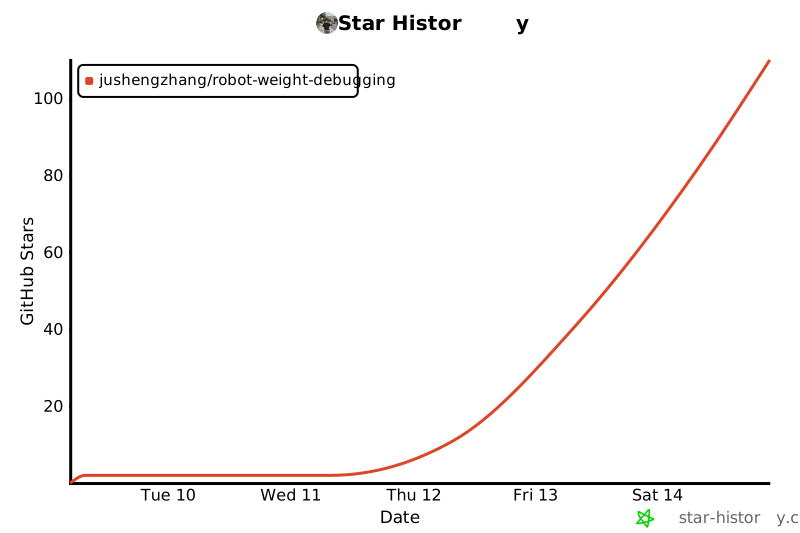
Stars110创建5 天前Forks9Issues0
简介
斯坦福团队让大模型直接读取并编辑预训练机器人策略的神经网络权重来修复行为缺陷,无需重新训练或环境交互。这对机器人部署后出现的边缘 case 修复提供了全新范式,可能减少大量人工调参成本。
First release for Can LLMs Debug Robots by Editing Their Weights? Code, 65-row edit, 16 experiment logs and evidence. V2 and real-robot experiments in progress.
媒体预览
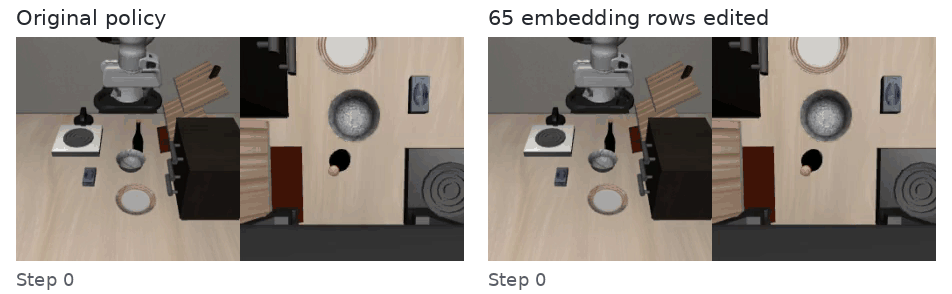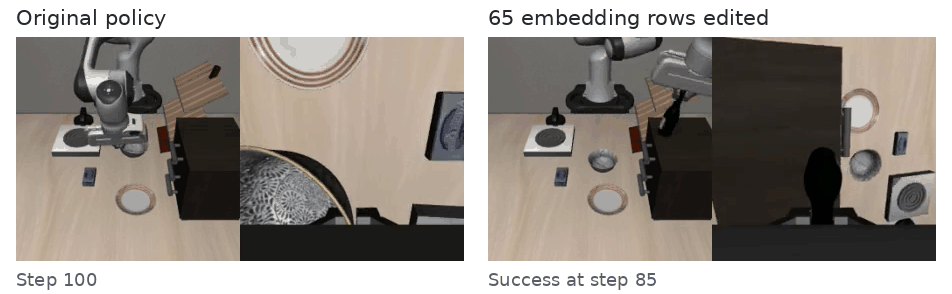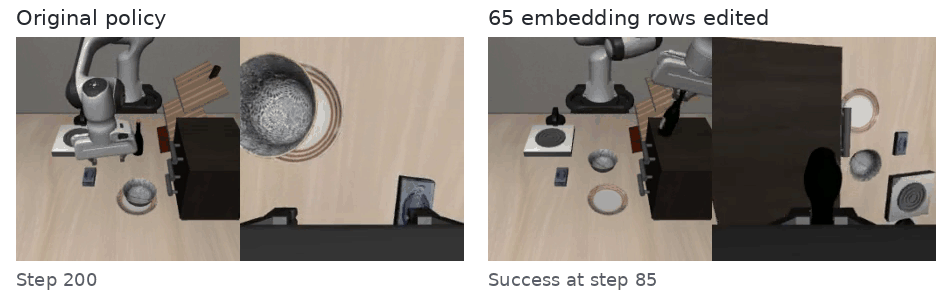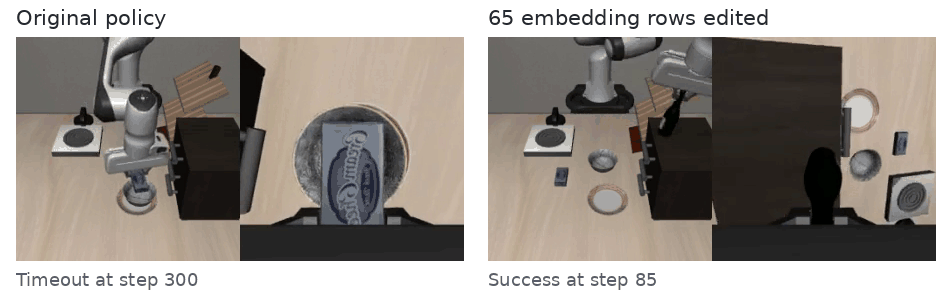
编辑判断
传统机器人策略调试要么收集新数据重训练,要么人工设计奖励函数,成本高且周期长。这个工作的核心突破是把策略网络当成'代码'来修——LLM看权重分布、识别故障神经元、做定点编辑,类似软件工程里的hotfix。
目前结果只在仿真环境验证,且用了GPT-6级别的模型做权重分析,算力门槛不低。但思路本身很有启发:如果未来能压缩到本地小模型执行,机器人现场维护的模式会完全改变。
做机器人落地的团队可以先跟踪他们的v2版本,特别是真实机器人实验的复现难度和编辑耗时,这是决定能否工程化的关键指标。
Star History
生态分析
Experimental
开创性探索LLM直接编辑机器人策略权重的前沿研究原型
独特价值:首创无需重训练或环境交互的权重级机器人调试范式