腾讯优图开源统一多模态解析器
推荐指数 74.0 NO. 030 · 2026.11.01
upvotes67comments3
简介
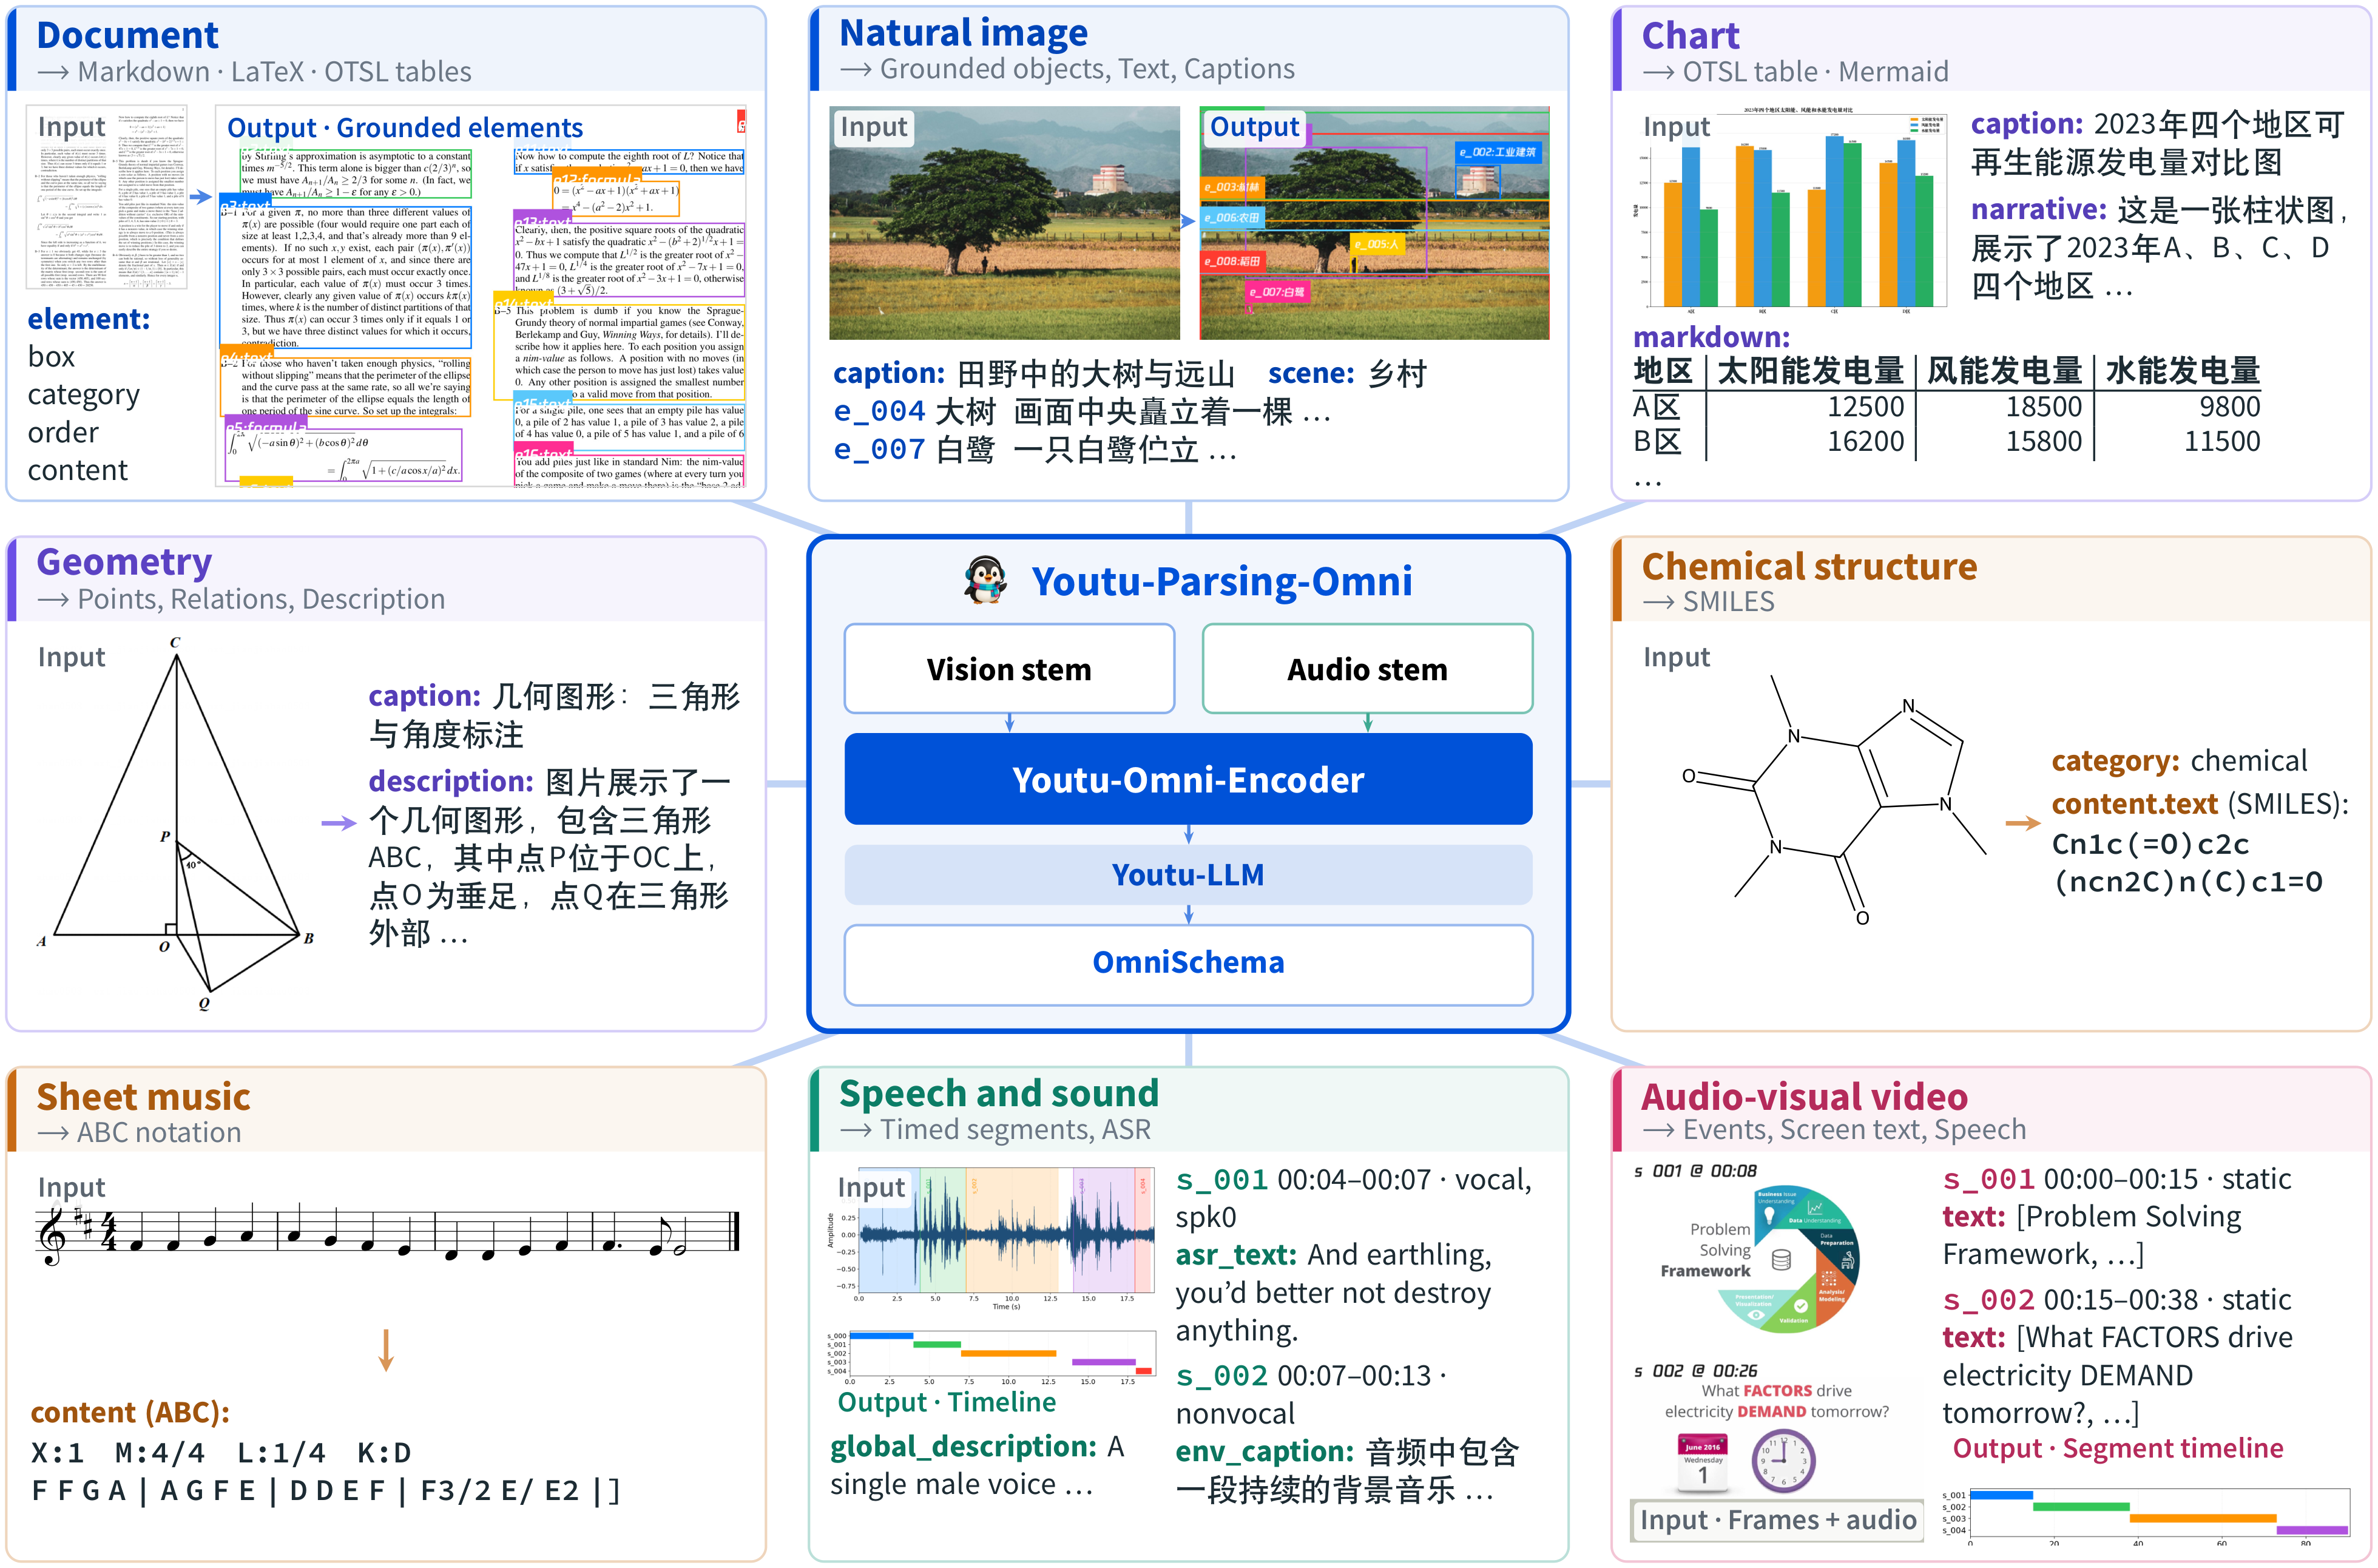
用一个编码器统一处理文档、图像、音频、视频,输出带时空坐标的结构化数据。对做 Agent 的团队意味着终于不用维护四套解析管线了。
媒体预览
编辑判断
当前多模态解析的主流做法是为每个模态单独搭 pipeline,比如文档用 LayoutLM、视频用 Whisper+CLIP 拼接,维护成本和误差累积都是痛点。这个工作的狠劲在于把语言模型的预训练权重直接初始化到视觉音频编码器,用共享空间硬压跨模态对齐问题。
自进化 on-policy 蒸馏是个值得盯的细节:模型自己生成伪标签再筛选高质量样本迭代,这比传统的离线蒸馏更省标注预算。优图团队没有公布训练成本,但从架构看 7B 级别的编码器跑视频解析对显存压力不小,建议先拿文档+图像的场景验证效果。
开源代码如果放出,做企业知识库、合规审查、多媒体搜索的团队可以优先试跑,特别是之前被 PaddleOCR + Whisper 拼接方案折磨过的工程组。