DeepSeek 把长文本预fill砍半到8B激活
推荐指数 84.0 NO. 022 · 2026.09.19
upvotes54comments2
为什么值得看
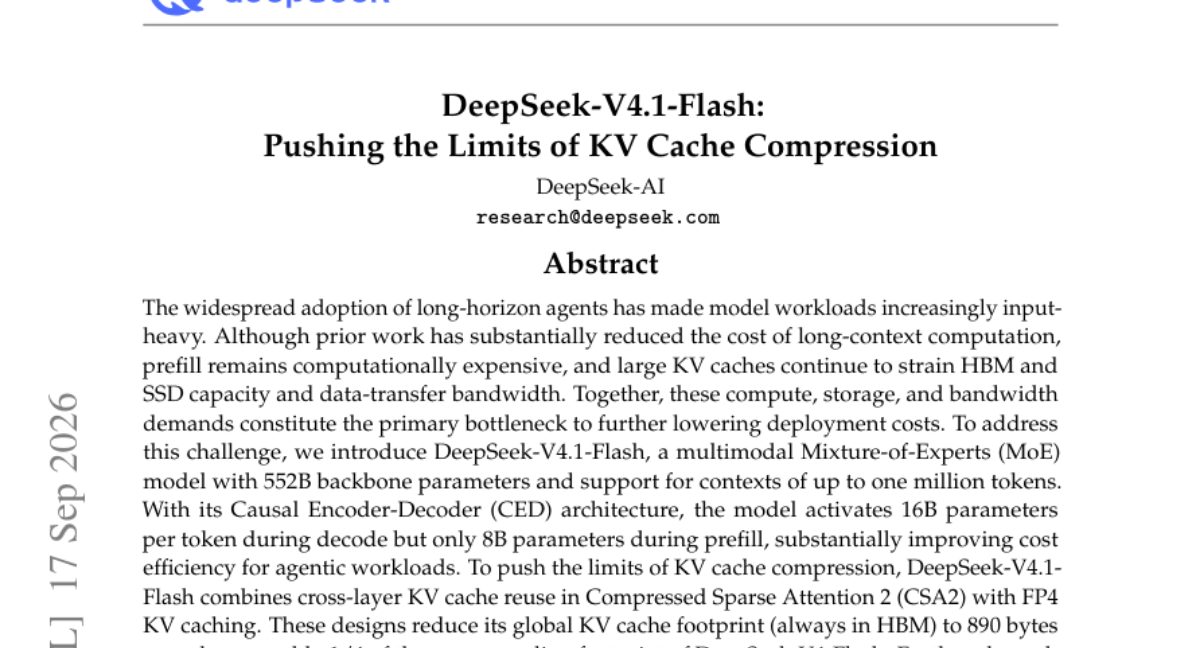
DeepSeek-V4.1-Flash 采用 CED 架构,在 552B 参数的 MoE 模型上将预fill阶段激活参数压到 8B(decode 为 16B),支持百万 token 上下文并大幅压缩 KV cache。对部署长文本 agent 的团队意味着显存和带宽成本可能显著下降,长上下文推理的经济性瓶颈有了新解法。
媒体预览
编辑判断
长上下文 agent 的部署成本结构里,prefill 算力和 KV cache 存储/带宽是两块硬骨头,之前 vLLM、SGLang 主要在 decode 阶段做优化,预fill 的 MoE 稀疏激活很少有人动。CED 架构把预fill 和 decode 的激活参数解耦开,本质是用架构设计换存储带宽,这个思路跟 Moonshot 的 KV cache 量化路线不同,更适合已经上了 MoE 的团队。
论文没有明确说是否开源权重或推理代码,但 DeepSeek 一贯开源,建议关注 HuggingFace 仓库更新。如果你在做百万 token 级别的文档分析或代码 agent,这个架构值得等复现后做成本测算。