用兄弟Harness救场RL训练失败
推荐指数 66.0 NO. 030 · 2026.11.07
upvotes54comments3
简介
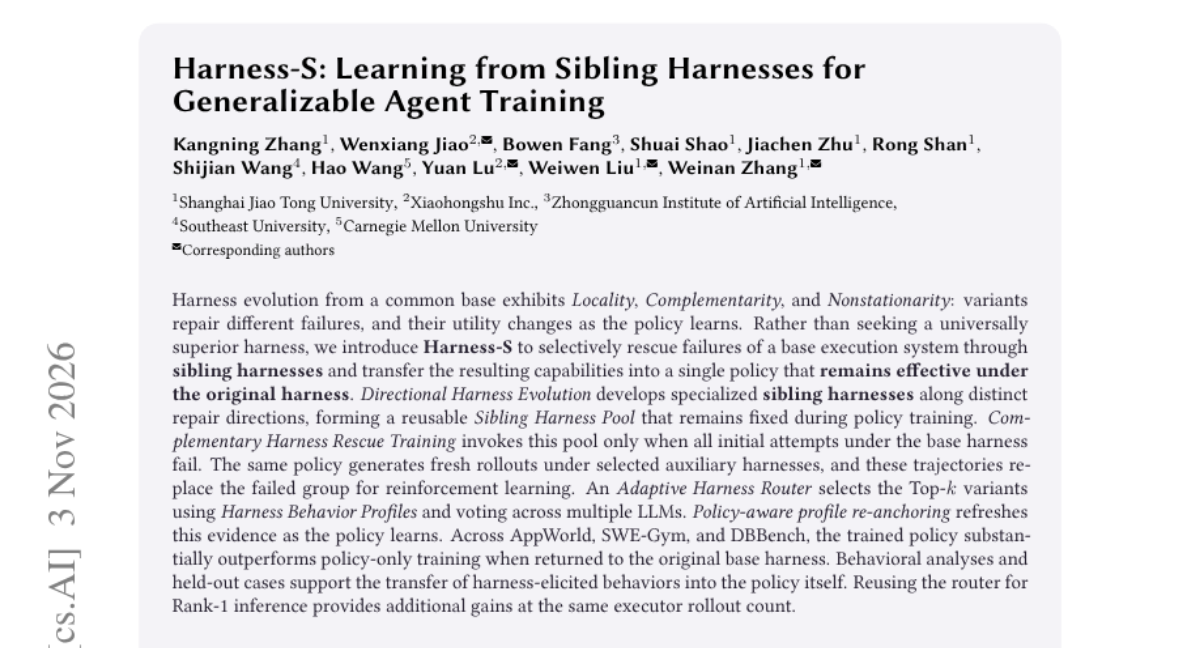
Harness-S是一种选择性救援训练方法,通过多个专门化的兄弟Harness替换失败的RL rollout,将能力迁移回原始策略。对Agent训练来说,这意味着不用重新设计环境,用Harness变体就能修复特定失败模式,提升泛化性。
媒体预览
编辑判断
之前Agent训练遇到环境失败,主流做法是人工重写奖励函数或做课程学习,成本高且难以覆盖长尾case。Harness-S的关键洞察是把Harness本身当成可进化的变量,而不是固定不变的训练场——这跟AutoML里用多个搜索空间互补的思路类似,但首次用到了RL的environment层面。
论文提到Locality和Nonstationarity两个性质,意味着兄弟Harness的效用会随策略进化而动态变化,实际落地需要维护一个Harness池并做在线筛选,工程复杂度不低。目前代码和实验环境未明确开源,想复现的团队建议先邮件作者确认是否有公开计划,54个upvotes在HF Papers里算中等热度,说明社区还在观望可复现性。