千亿参数模型训练不再崩溃
推荐指数 85.0 NO. 001 · 2026.09.20
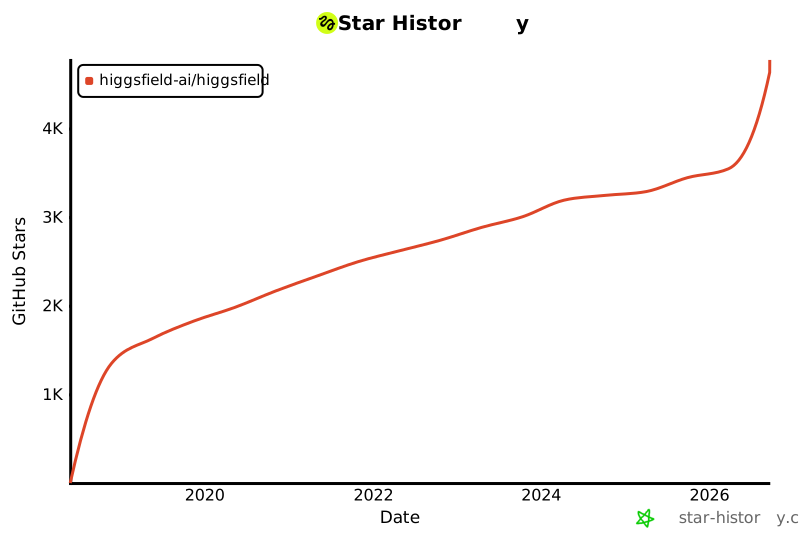
Stars4,880
为什么值得看
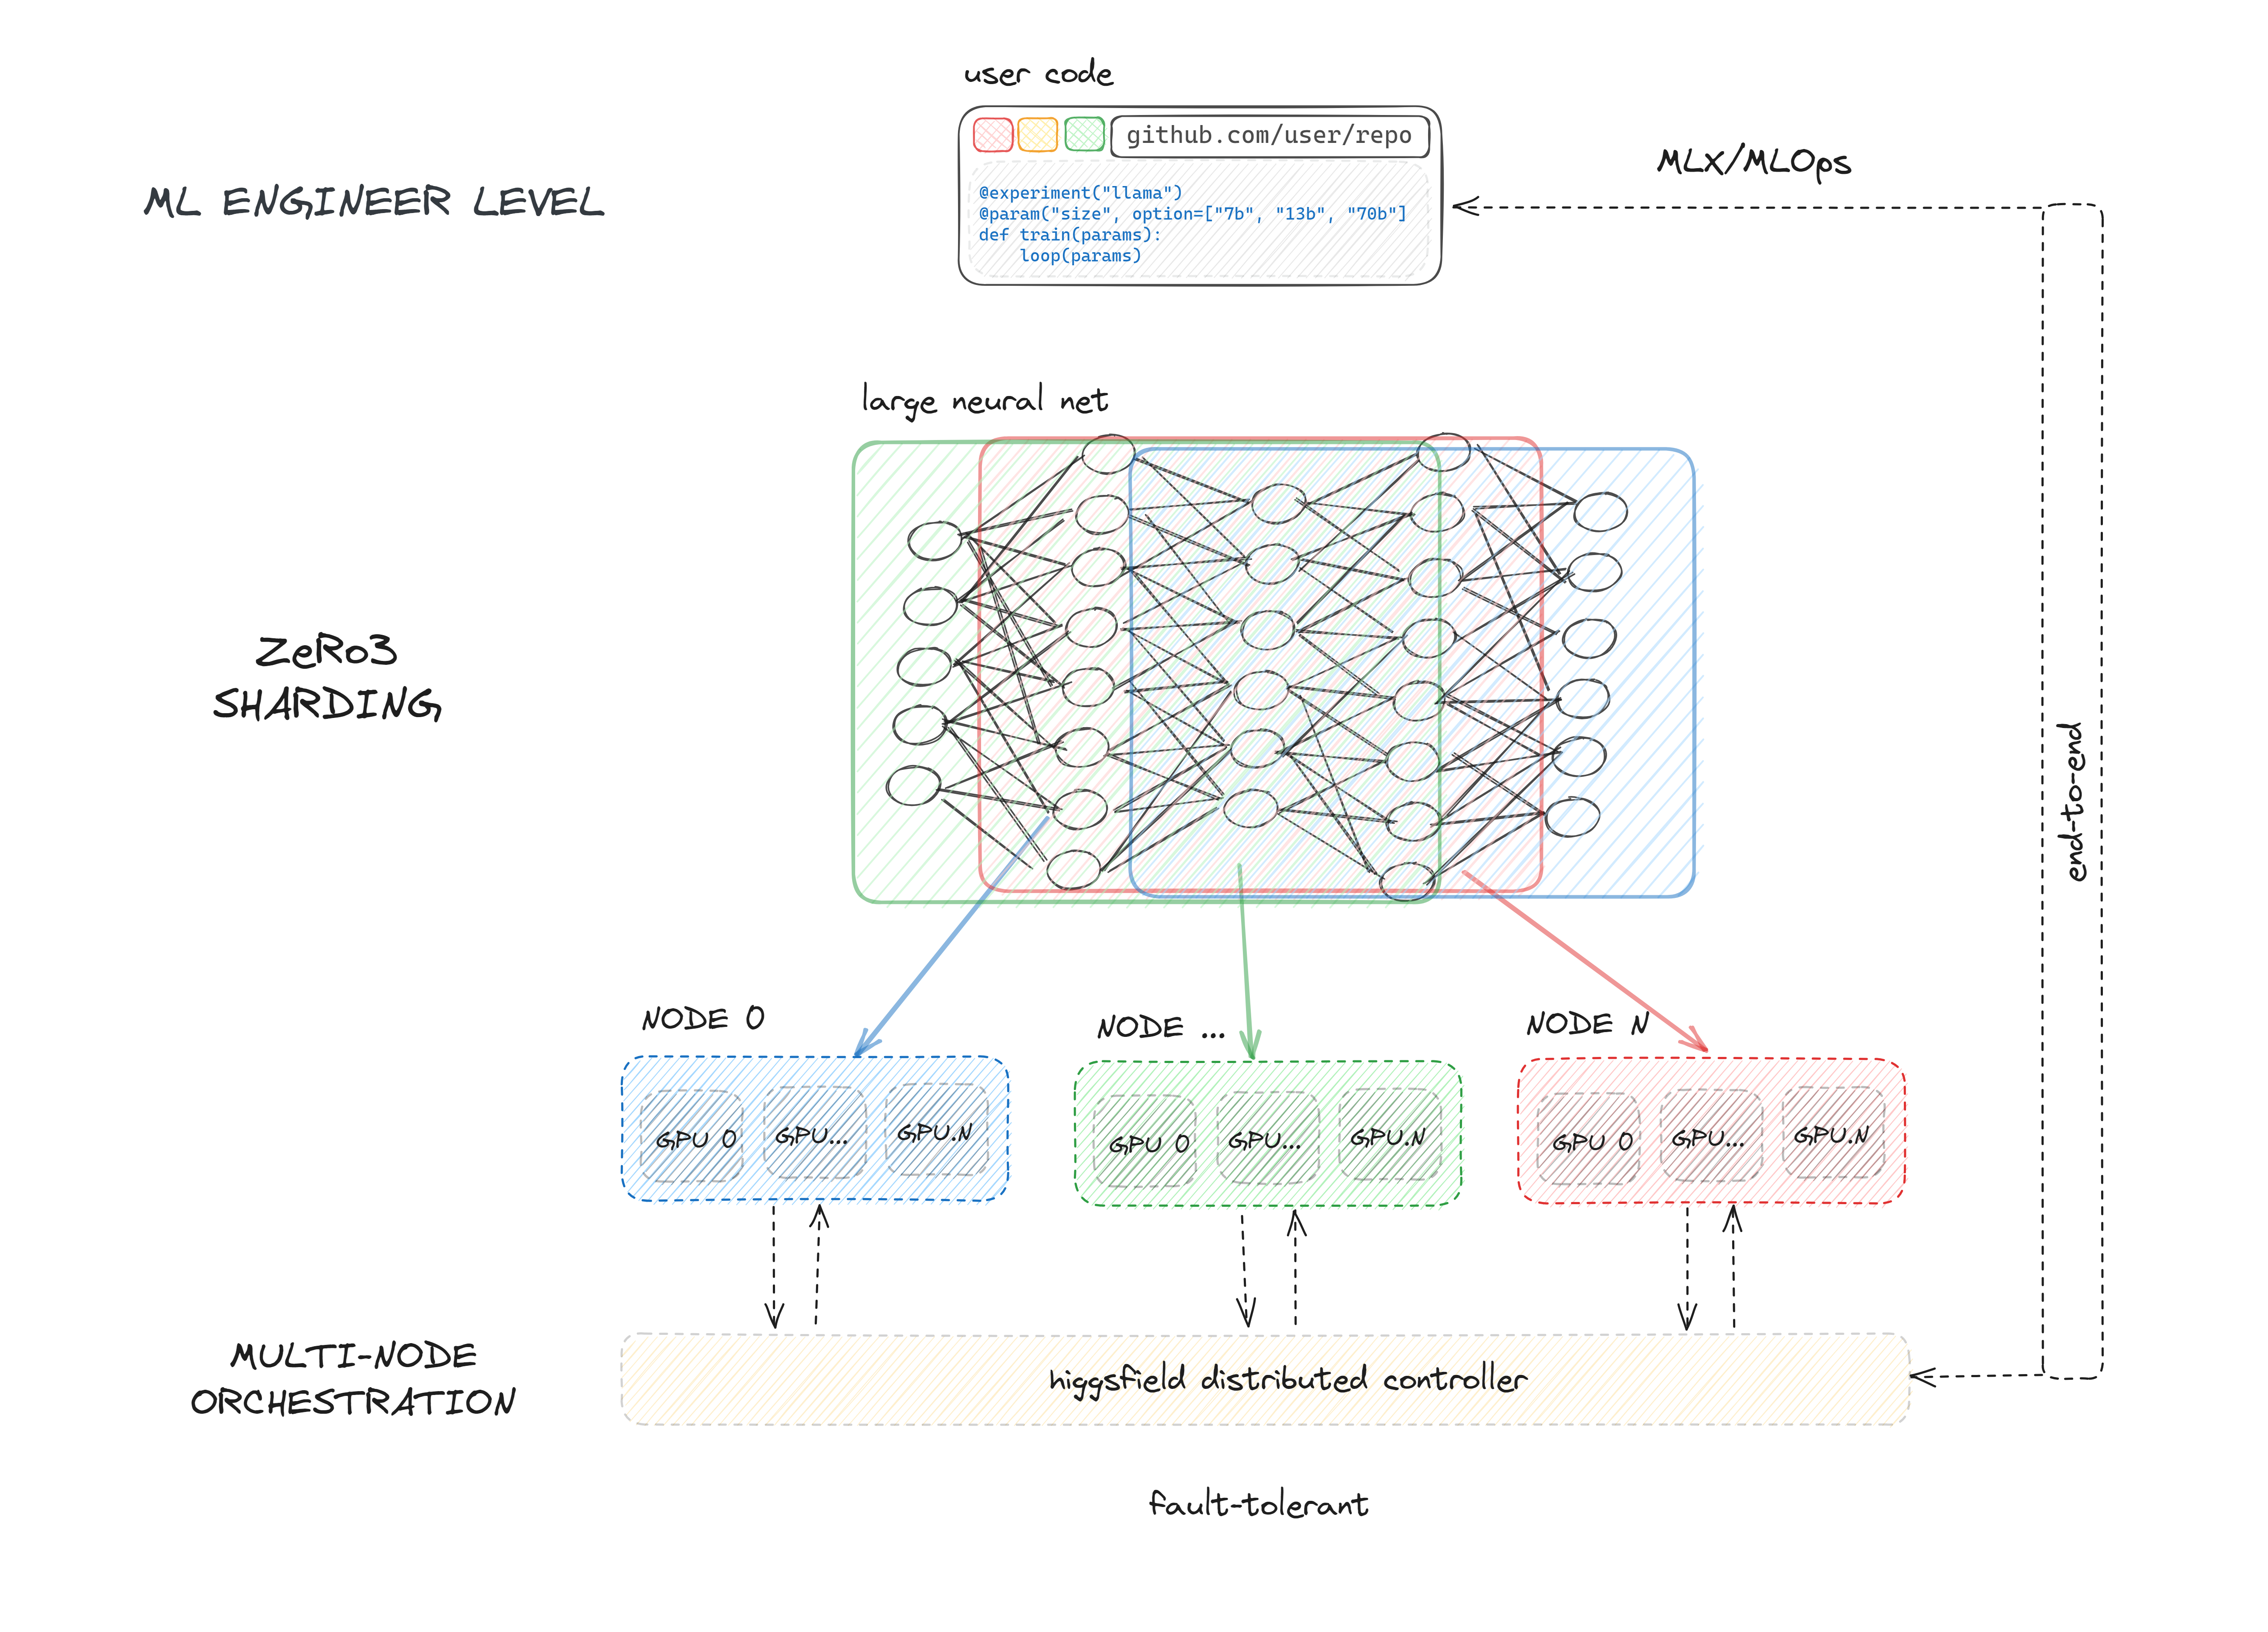
Higgsfield 是一个开源容错 GPU 编排框架,专为千亿到万亿参数大模型训练设计,支持 ZeRO-3 和 FSDP 高效分片。对苦于多节点训练频繁失败、资源调度混乱的 AI 基础设施团队,这可能是比原生 DeepSpeed 更省心的替代方案。
Fault-tolerant, highly scalable GPU orchestration, and a machine learning framework designed for training models with billions to trillions of parameters
媒体预览
编辑判断
多节点大模型训练的痛点从来不是'能不能跑',而是'跑三天半夜三点挂了怎么办'。目前业界主流靠 DeepSpeed + Slurm 自搭,但容错和弹性扩缩容需要大量胶水代码,很多团队干脆写死 checkpoint 频率来兜底。
Higgsfield 把资源调度层和训练框架层做了统一,类似 Kubernetes 上跑 Volcano + DeepSpeed 的集成体验,但针对 LLM 训练做了专门优化。跟 MosaicML 的 Streaming 或 Amazon SageMaker 的分布式训练比,它是纯开源自托管路线,适合数据合规要求严、不愿上云的大厂和研究机构。
如果你现在用 torchrun + DeepSpeed 手搓多节点,且每周至少遇到一次 NCCL timeout 或节点掉线,这个框架的容错机制值得替换成试点。
Star History
生态分析
Beta
填补DeepSpeed与Kubernetes之间的容错大模型训练编排层
独特价值:以容错为核心差异化,降低多节点大训练故障恢复的人工成本