122B模型64分钟量化,内存仅需32.5GB
推荐指数 76.0 NO. 001 · 2026.11.13
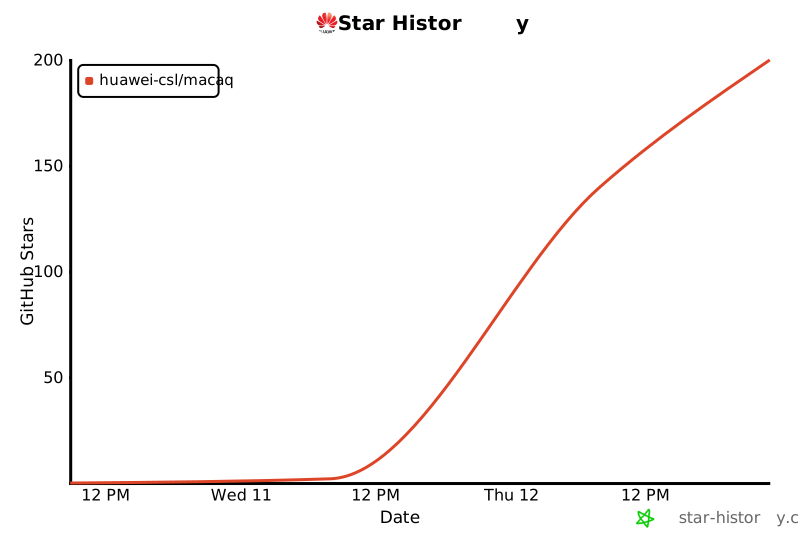
Stars200创建2 天前Forks11Issues2
简介
MACaQ 是支持文本、图像、视频、音频的多模态模型量化工具,兼容 llama.cpp 和 vLLM。量化速度比 MR-GPTQ 和 DuQuant++ 快 11 倍,同时 perplexity 更低或持平,还可用 MACaQ-R 精调现有 GGUF 模型适配业务负载。
SOTA model-agnostic quantization for GGUF, local inference and beyond. Quantize and run text, image, video and audio models with llama.cpp, vLLM, Diffusers and PyTorch.
媒体预览
编辑判断
量化大模型一直是本地部署的瓶颈,之前主流方案如 AutoGPTQ、AWQ 在处理百B级模型时要么显存爆炸要么耗时数小时,团队往往需要租 A100 48GB 甚至多卡才能完成。MACaQ 把门槛压到单卡 32.5GB,这意味着 RTX 4090 或 Apple Silicon 大内存机型就能在本地跑 122B 量化,对中小团队和隐私敏感场景是实质性解锁。
更值得关注的是 MACaQ-R 的增量精调能力:现有 GGUF 模型可以直接优化适配特定 workload,不用重新走完整量化流程。如果你已经在用 llama.cpp 部署但苦于量化质量损失,这是目前少数能无缝接入的改良方案。
Star History
生态分析
Beta
昇腾生态的多模态GGUF量化工具,衔接训练框架与边缘推理引擎
独特价值:唯一支持文图音视频四模态的GGUF量化方案,速度领先11倍
竞品: