RAG评测工具:自审计判分器
推荐指数 68.0 NO. 003 · 2026.11.07
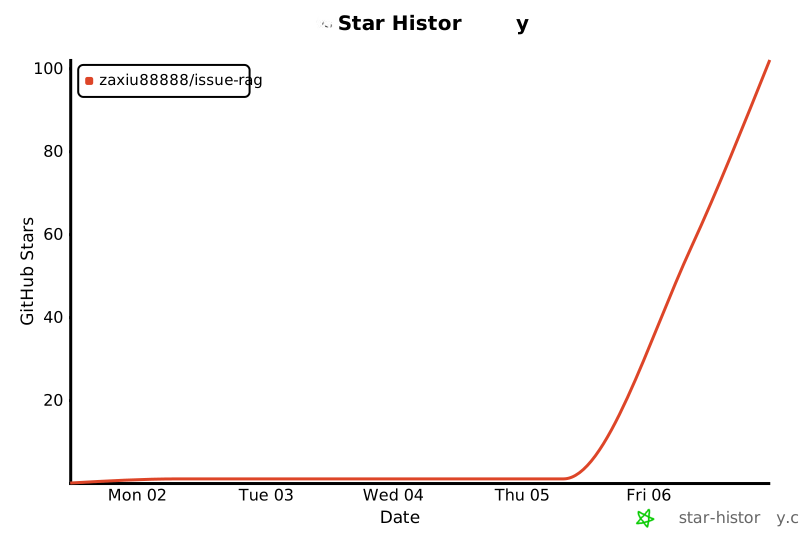
Stars102创建5 天前Forks3Issues0
简介
一个面向开源仓库issue的RAG系统,核心创新是用95条人工复核问题+四种判分器交叉验证,把检索增益的测量误差控制在可量化范围。对苦于RAG效果"感觉有提升但说不清"的工程师,提供了可复现的评估范式。
RAG over GitHub issues, with a hand-reviewed eval set and an audit of the judge itself. Reports the interval, not just the best number.
编辑判断
RAG圈子里最头疼的不是做不出来,而是测不明白——换个大模型当judge,分数波动比模型差异还大。这个项目把判分器本身当变量来审计,用κ系数和盲评把噪声区间标出来,这比单纯刷分更有工程价值。
之前类似的系统性评测多见于学术论文(如RAGAS、TruLens),但要么闭源要么绑定特定框架。issue-rag的优势是端到端可复现,连GitHub Pages上的95条case都能逐条翻检。
如果你团队正在用LangSmith或Weights & Biases做RAG实验,建议把它的判分方法论嫁接进去,至少能少吵几次"这个配置到底好不好"。
Star History
生态分析
Beta
面向开源issue场景的RAG可量化评估基准工具
独特价值:以人工复核+多判分器交叉验证实现检索增益的区间化测量
竞品:
shashank11yadav/pytest-triage shadow-mode分类助手,无人工复核评估体系