视频模型做图像生成,一模型通吃多条件
推荐指数 70.0 NO. 029 · 2026.11.03
upvotes112comments2
简介
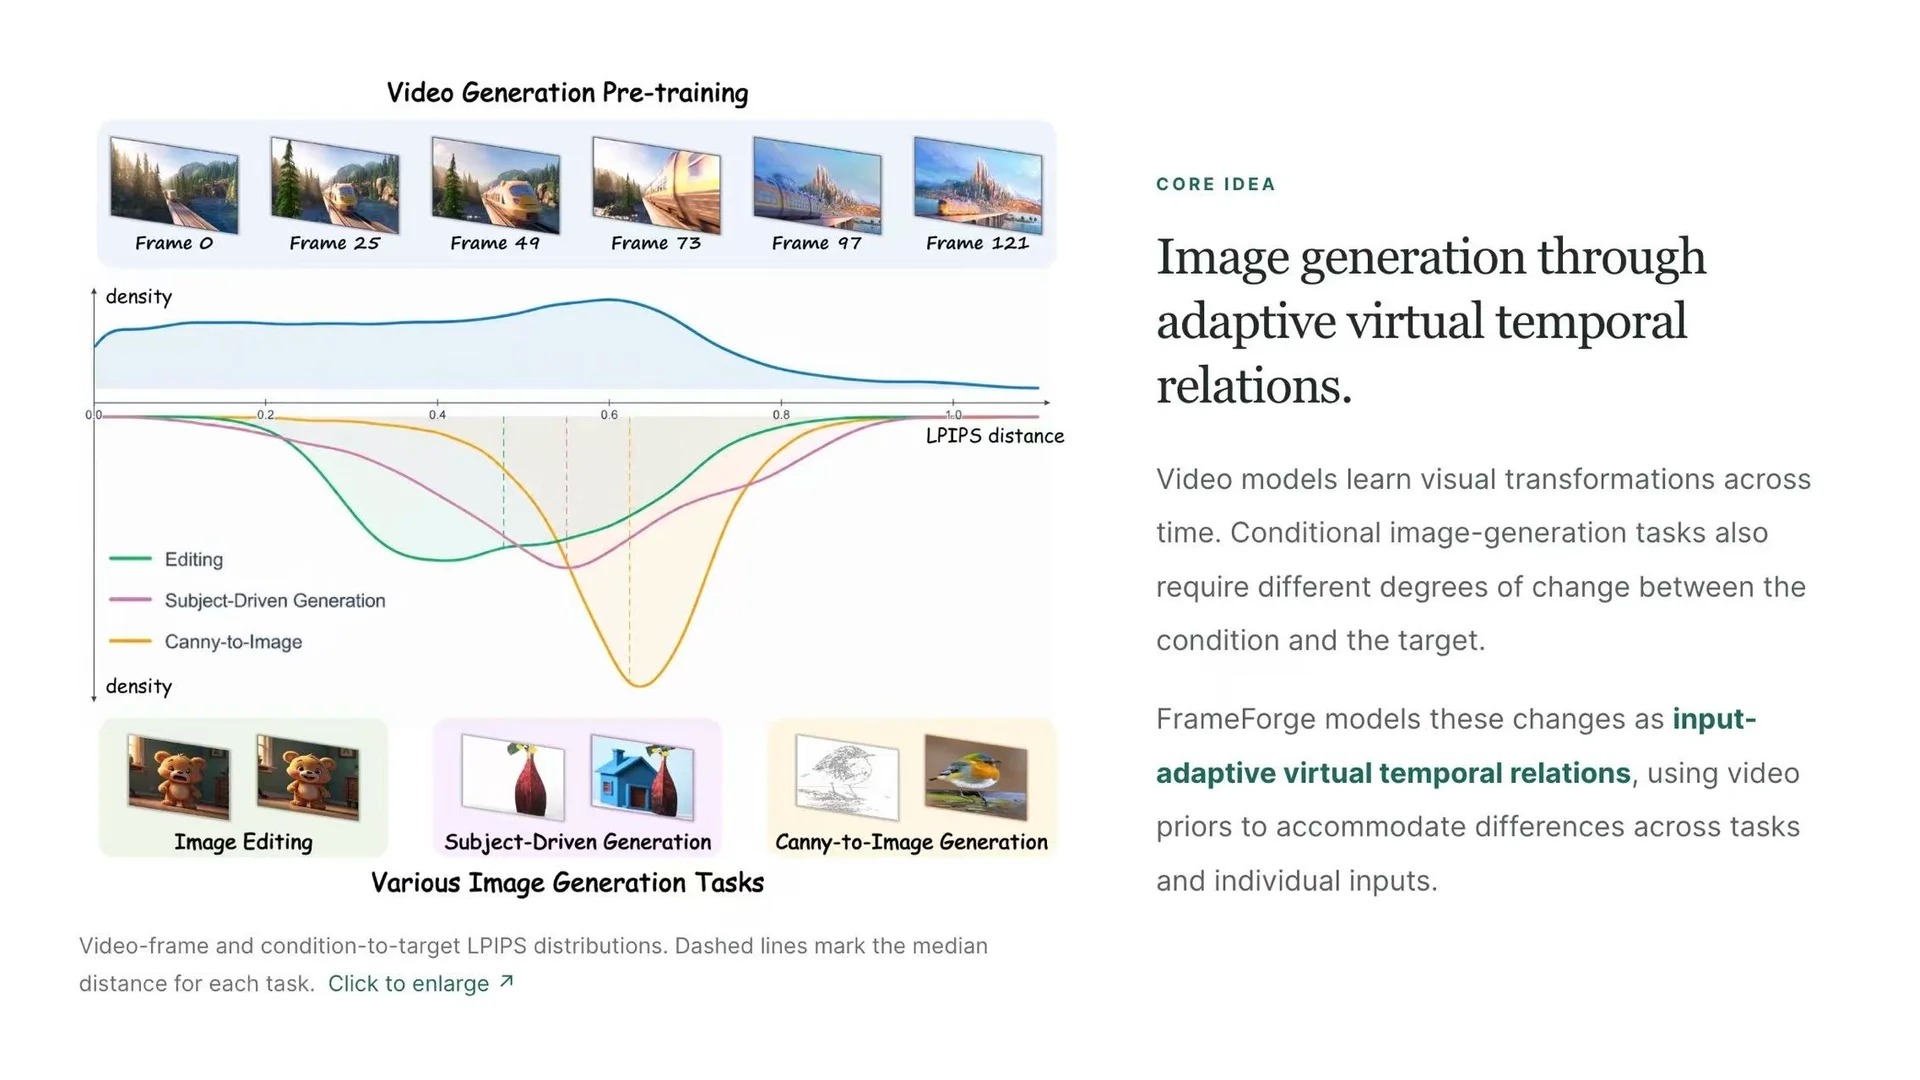
FrameForge 把预训练视频模型改造成统一条件图像生成器,通过动态时间专家自动适配不同任务的条件-目标关系。对做文生图、图像编辑、多模态生成的团队来说,这意味着可能用一个模型替代多个专用模型,减少维护成本。
媒体预览
编辑判断
现有条件图像生成通常给每个任务单独训一个模型,比如 ControlNet 系列、IP-Adapter、InstructPix2Pix 都是各管一摊。FrameForge 的关键洞察是视频模型本身就编码了时间维度的视觉变换,与其硬编码条件到固定帧位置,不如让模型自己学怎么配。这相当于把"任务设计"变成了"路由选择",动态专家机制类似 MoE 的思路但用在时间轴上。
不过论文没有给出与 ControlNet-XS、T2I-Adapter 这些轻量级方案的显存和速度对比,视频模型做图像生成的 overhead 是否划算还存疑。如果开源代码能支持 8G 显存跑推理,对中小团队吸引力会大很多。