评测LLM能否从零造出Coding Agent
推荐指数 70.0 NO. 003 · 2026.10.18
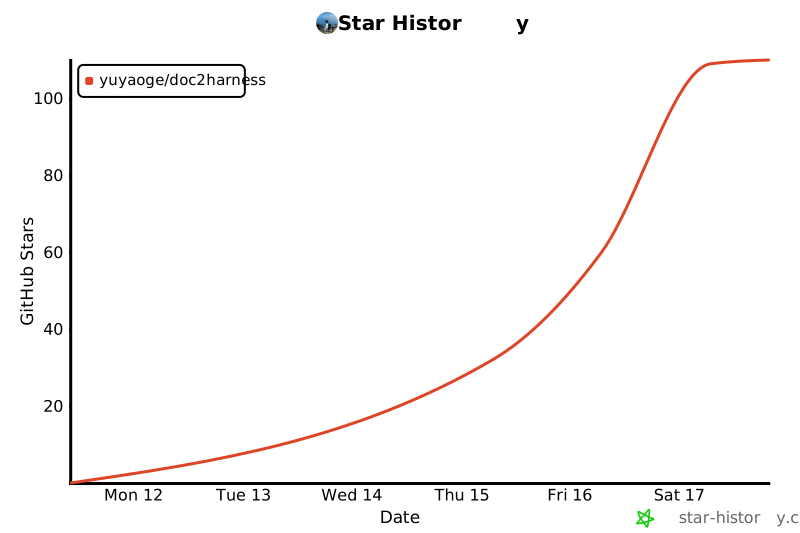
Stars110创建6 天前Forks1Issues1
为什么值得看
Doc2Harness 是一个两阶段基准测试:先让模型根据开发文档实现完整的 Coding Agent 框架(harness),再用固定 mock 模型测试其端到端运行效果。它填补了现有评测只测"写补丁"不测"造工具"的空白,对评估 LLM 的工程架构能力更真实。
Official Code for the paper "Doc2Harness: Benchmarking LLMs on Long-Horizon Harness Engineering of Coding Agents "
媒体预览
编辑判断
现有 Coding Agent 评测如 SWE-bench 主要测模型在现成框架里修 bug 的能力,但真实场景需要模型从零搭建工具链。Doc2Harness 把"造轮子"和"用轮子"解耦,这是关键设计:Stage 1 测架构设计,Stage 2 测运行稳定性,避免"写得好但跑不通"的虚假高分。
目前 110 stars 但 forks 仅 1,说明围观多、动手少。如果你是做 Agent 框架或 AutoGPT 类项目的团队,建议直接跑它的 Stage 1 用例来检验自家模型的长程代码生成能力,比自建评测成本低很多。Swarm、CrewAI 等框架的维护者也可以参考它的 harness 接口设计来标准化 Agent 评测。
Star History
生态分析
Experimental
首个聚焦LLM从文档生成完整Coding Agent框架的专项基准
独特价值:填补写补丁到造工具的评测空白,测工程架构而非代码片段
竞品: