纯C跑2.8T参数MoE模型
推荐指数 81.0 NO. 003 · 2026.09.11
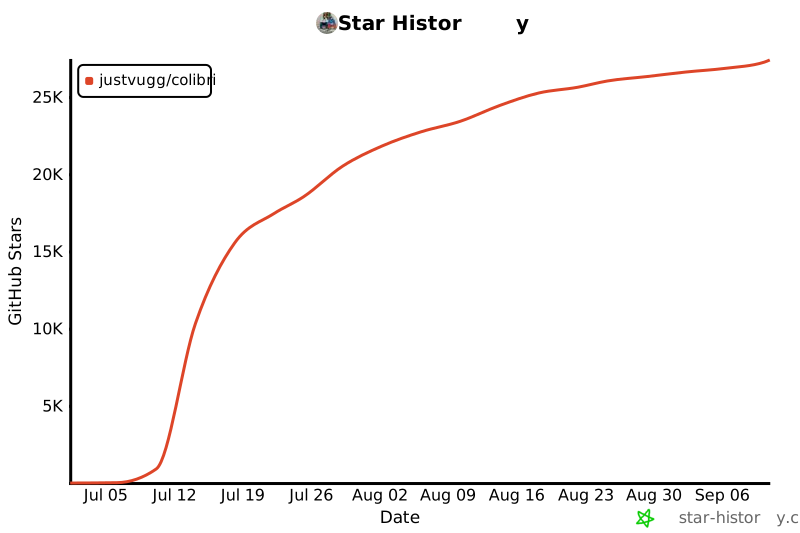
Stars27,402
为什么值得看
Colibrì 是一个零依赖的纯C推理引擎,通过统一存储/RAM/VRAM层级让消费级硬件直接运行744B到2.8T参数的MoE大模型。对AI工程师意味着无需高端GPU集群即可本地部署前沿模型,显著降低推理基础设施成本。
Run frontier MoE models on hardware you already own — pure C, zero deps, experts streamed from disk. Tiny engine, immense model. 🐦
媒体预览
编辑判断
MoE模型推理的痛点一直是显存墙和专家调度开销,之前主流方案要么走vLLM/SGLang的GPU集群路线,要么用llama.cpp做量化压缩牺牲质量。Colibrì的核心差异是把CPU内存、SSD甚至网络存储拉进同一个统一寻址空间,用C语言裸写调度逻辑绕过Python生态的内存冗余。
这跟llama.cpp的CPU offload有本质区别:llama.cpp是分层加载,Colibrì是把整个存储层级当成一个cache-coherent的内存池。如果你在做边缘部署或者成本敏感的SaaS推理,值得对比测试它和Ollama+llama.cpp在同等硬件上的吞吐量差异。
目前支持Kimi K3和DeepSeek V4 Flash等国产模型很及时,但生产环境需要警惕纯C引擎的调试生态和分布式多卡扩展能力。
Star History
生态分析
Beta
消费级硬件运行超大规模MoE模型的极简推理引擎新入局者
独特价值:纯C零依赖+磁盘流式专家,突破显存限制跑2.8T模型
竞品: