llama.cpp 免训练绕过安全限制
推荐指数 67.0 NO. 002 · 2026.10.26
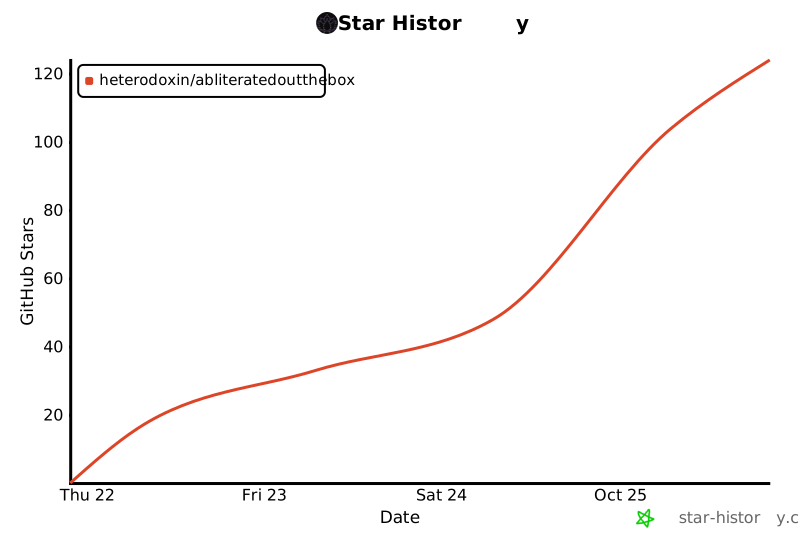
Stars124创建3 天前Forks14Issues0
简介
AbliteratedOutTheBox 是 llama.cpp 的分支,能在推理时动态移除模型的拒绝机制,无需微调或修改权重文件。对研究模型安全机制、红队测试和越狱防御的工程师有直接价值。
llama.cpp fork that abliterates at inference
媒体预览
编辑判断
之前绕过模型安全限制的主流方法是模型 abliteration,需要离线修改权重并重新保存文件,操作重且不可逆。这个项目把 abliteration 搬到了推理时,用 prompt 自身提取 comply/refuse 方向,通过前向 gate 决定是否激活编辑,131 种架构共享同一套代码路径。
跟直接微调或 GCG 优化攻击相比,它的优势是零额外存储、零训练成本、对原始模型零侵入,这对需要批量测试不同模型安全边界的红队团队很友好。但这也意味着防御方更难通过文件哈希或权重扫描来检测模型是否被篡改,安全审计的假设需要更新。
如果你在做 AI 安全基础设施或模型托管平台,建议关注这种「无痕化」攻击范式的检测方案,传统的静态校验正在失效。
Star History
生态分析
Experimental
llama.cpp安全研究分支,聚焦推理时模型对齐机制的动态移除
独特价值:无需改权重即可推理时消融拒绝机制,降低红队测试门槛
竞品: