LLM推理容量规划实战手册
推荐指数 79.0 NO. 003 · 2026.09.07
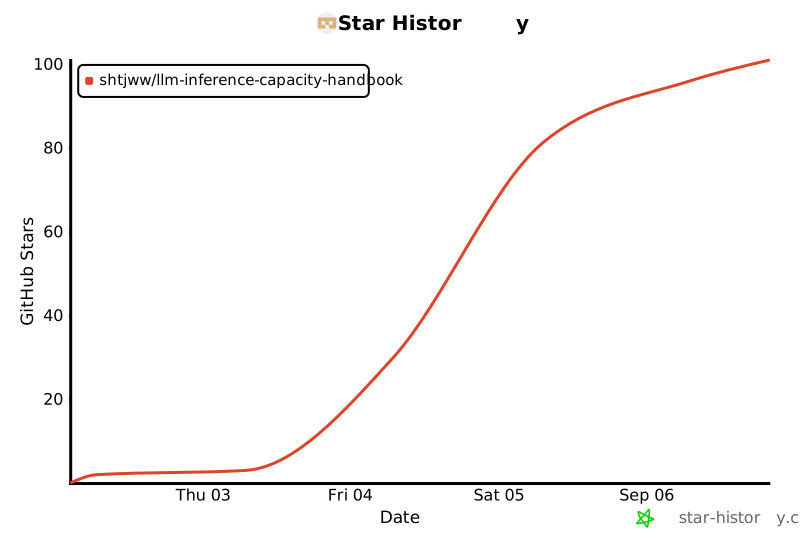
Stars101创建4 天前Forks0Issues0
为什么值得看
一本中文开源手册,用公式+算例系统化解决大模型推理的容量规划问题:给定GPU算力,精确计算QPS、TTFT、TPOT和P95延迟。填补了行业中间层空白——既不是入门科普也不是源码解析,而是可直接照抄的SOP,覆盖从单机到500万DAU的采购决策。
大模型推理案头手册(开源版):给定 GPU 算力,一个模型能扛多少 QPS?三层模型 × 三面墙 × 排队论 × 开环压测
编辑判断
行业里做推理容量规划的人大多在拍脑袋,常见陷阱是拿闭环压测的吞吐当真实容量——这隐含了系统利用率100%的假设,而排队论告诉我们此时等待时间趋于无穷。这本手册的价值在于把vLLM社区里散落的经验(比如Prefill/Decode分离调度、chunked prefill)锚定到可量化的公式上,让工程师能和财务对齐"买多少卡"的决策。
跟NVIDIA的Triton Model Analyzer或Anyscale的LLMPerf相比,这本手册不是自动调参工具,而是教你怎么手算验证这些工具的输出是否合理。最适合的场景是:你已经用vLLM跑通了服务,但要在SLA里写死P95延迟、或者要向老板解释为什么需要再买20张H100——这时候需要的不只是benchmark数字,而是能推导数字背后的物理约束。
Star History
生态分析
Beta
中文LLM推理容量规划方法论层,填补工具与源码之间的SOP空白
独特价值:公式化+算例驱动的中文手册,覆盖单机到百万DAU的采购决策SOP