SGLang Rust 前端部署 Qwen3.6 推理服务
推荐指数 62.0 NO. 005 · 2026.09.19
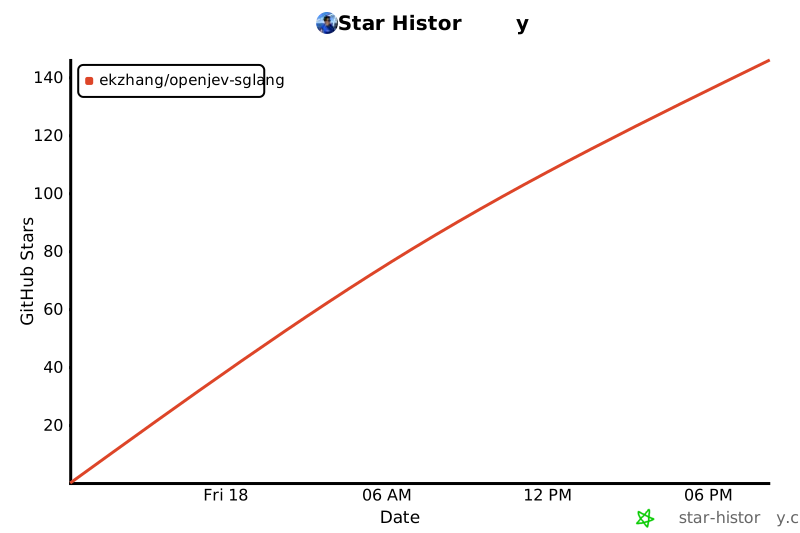
Stars146创建1 天前Forks12Issues1
为什么值得看
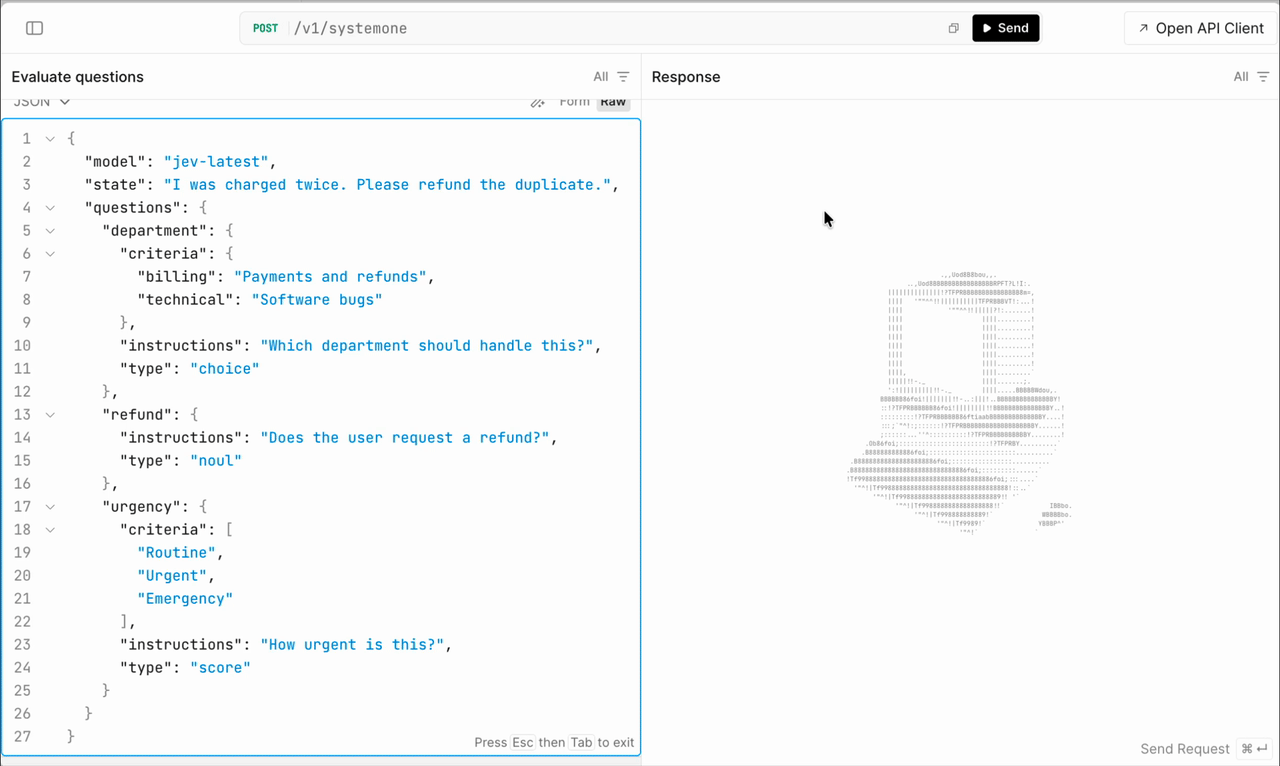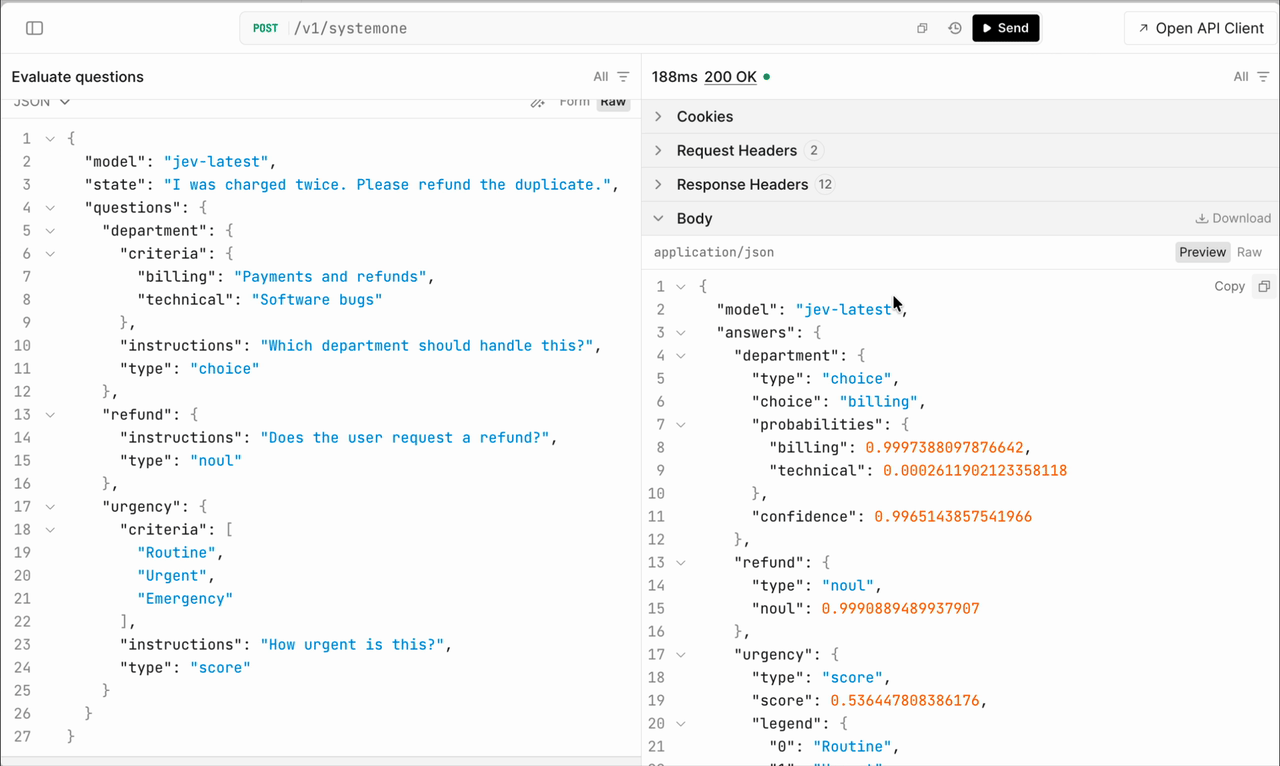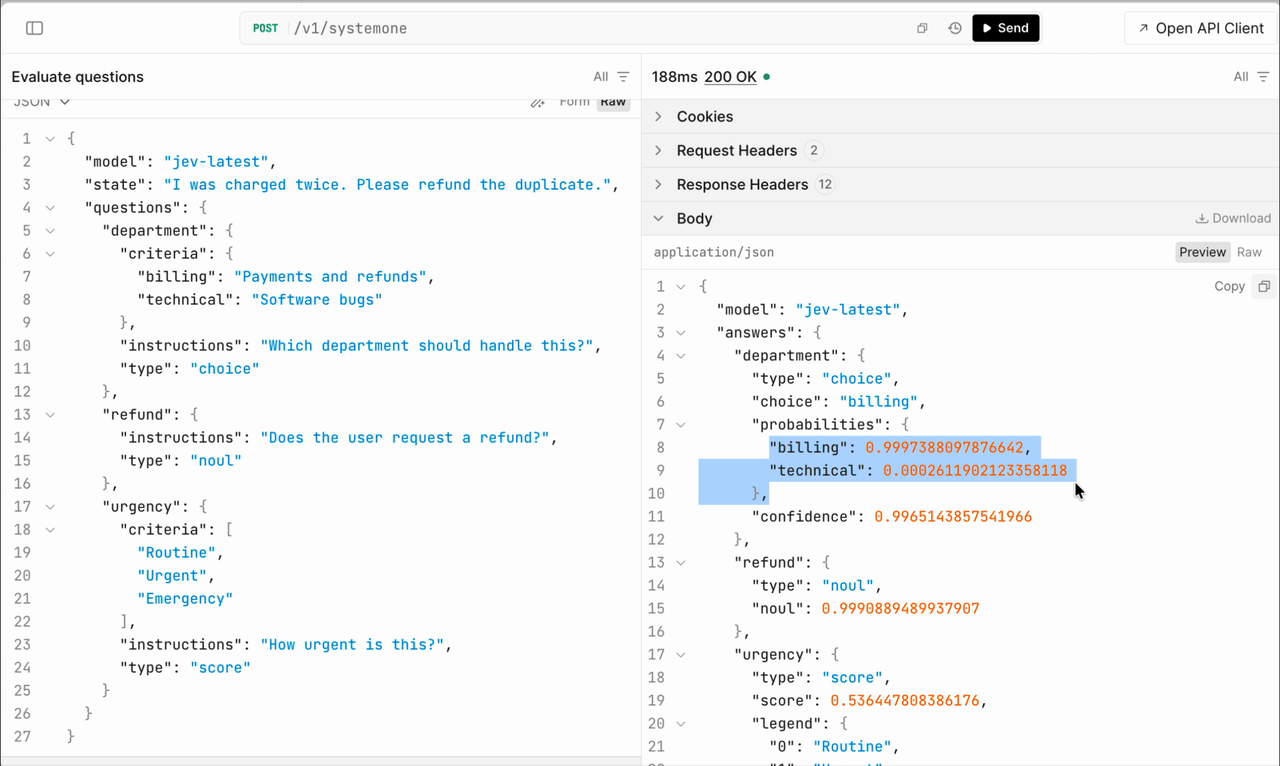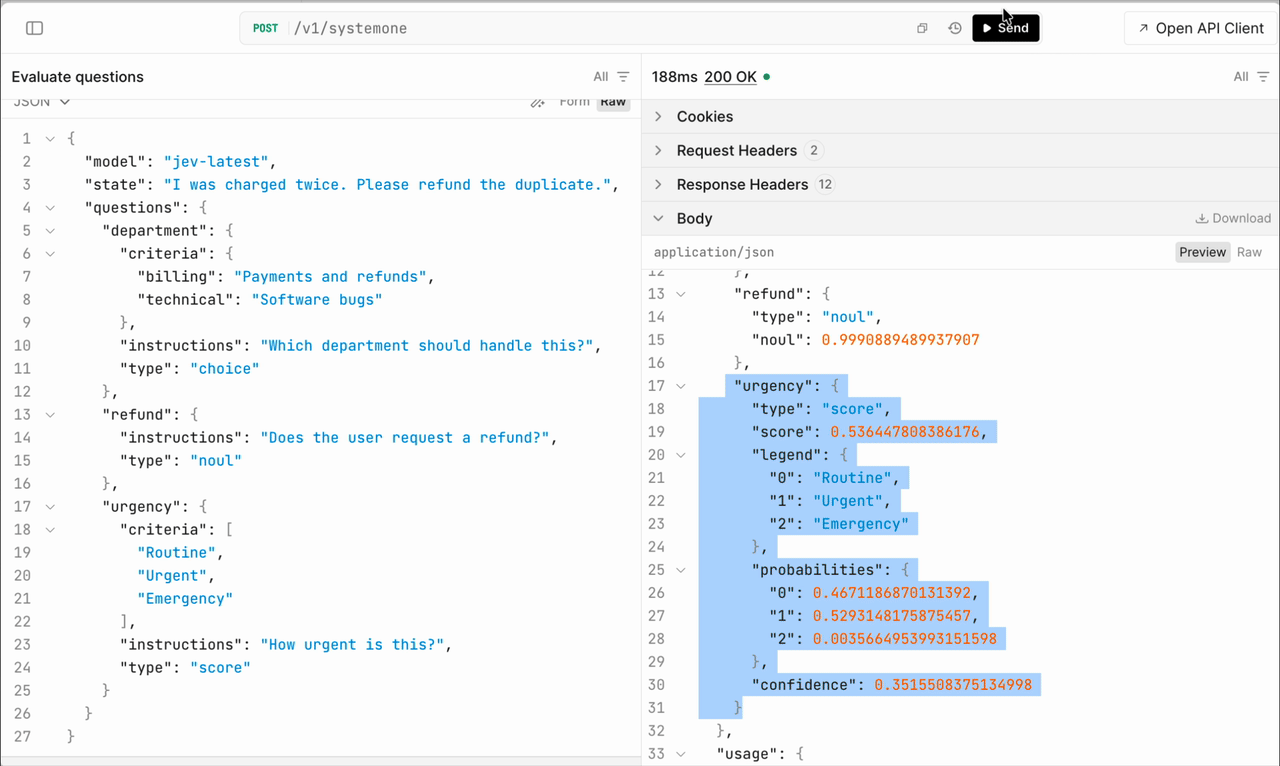
基于 SGLang 0.5.19 Rust 前端搭建的 HTTP API 服务,单容器单 B200 运行 Qwen3.6-35B-A3B,支持 radix 缓存和可中断 prefill CUDA 图。API 层与 CUDA 依赖解耦,本地仅需安装纯 Python 工具链。
Jev-compatible API endpoint based on open models (prefill-only)
媒体预览
编辑判断
这个项目的架构设计比模型本身更值得看:把 CUDA 运行时锁死在 SGLang 容器里,API 层用 Rust-backed tokenizer + uvloop + 连接池做纯异步代理,解决了本地开发装 CUDA 的痛点。这跟 vLLM 的典型部署(开发机也要装全套依赖)形成对比,对需要多人协作、快速迭代的团队更友好。
不过要注意一个细节:autoscale to zero 是双刃剑,B200 冷启动时间可能让首次请求体验很差。作者留了 keep_warm 的口子,实际生产建议至少留 1-2 个常驻实例。如果你在用 vLLM 且被部署复杂性困扰,可以把它当作 SGLang 生产化的参考实现来读。
Star History
生态分析
Experimental
面向 Jev 生态的轻量开源推理服务端,专注纯 prefill 场景与部署简化。
独特价值:Rust 前端解耦 CUDA 依赖,单容器单卡运行大模型,降低本地开发门槛。