从零纯PyTorch训练立法领域LLM
推荐指数 58.0 NO. 008 · 2026.10.15
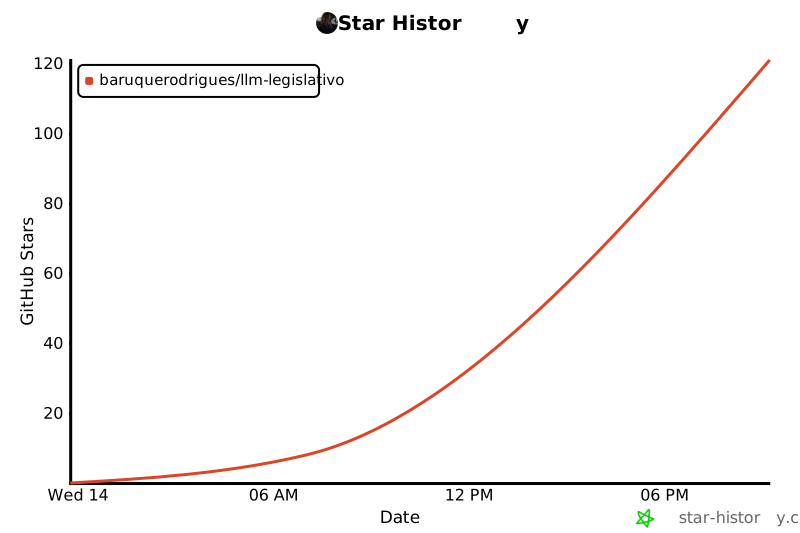
Stars121创建今天Forks10Issues0
为什么值得看
巴西研究者基于国会历史文档构建大规模语料库,用纯PyTorch从零训练因果Transformer,完全脱离预训练权重和Hugging Face生态。对想深入理解LLM训练全链路、或需在垂直领域(法律/政务)自建可控模型的团队有直接参考价值。
Corpus legislativo brasileiro em larga escala e modelo Transformer causal treinado do zero em PyTorch puro.
编辑判断
大多数垂直领域LLM项目依赖Llama等基座做继续预训练,这个项目反其道而行,把数据工程、tokenizer训练、分布式训练、评估全链路自己实现了一遍。价值不在模型性能,而在可作为教学级参考实现——尤其适合想搞清楚Hugging Face到底帮你隐藏了哪些细节的人。
法律/政务场景的模型需求往往涉及数据主权和审计要求,完全自研管线虽然成本高,但在某些合规场景下是刚需。如果你正被客户追问模型训练过程的可解释性,这个项目的方法论比直接说用LoRA微调更有说服力。
Star History
生态分析
Experimental
巴西法律政务垂直领域从零训练LLM的独立开源实践,填补葡语法律大模型空白。
独特价值:纯PyTorch自研训练链路,完全脱离HF生态,提供垂直领域可控模型自建范式。