LLM 输入压缩 8 倍降本
Headroom 在本地对 AI agent 的输入(工具输出、RAG 片段、对话历史等)进行压缩后再送入 LLM,官方示例中 10144 tokens 压到 1260 tokens 且答案不变。对 token 成本敏感、agent 调用频繁的场景可直接降低 80%+ 费用,且无需把数据发到外部压缩服务。
Compress tool outputs, logs, files, and RAG chunks before they reach the LLM. 20% fewer tokens for coding agents, 60-95% fewer tokens for JSON, same answers. Library, proxy, MCP server.

之前大家控制 context 成本主要靠 prompt 精简、RAG 重排序截断或换便宜模型,Headroom 走的是另一条路——对已有内容做语义压缩保留关键信息。和类似方向的 Contextual AI 的 RAG2.0 或 LangChain 的 contextual compression 相比,Headroom 的差异化是端到端代理层集成(proxy/agent wrap/MCP 三种形态),零代码或一行命令即可接入,不需要改造现有 RAG 管线。
最该试的人群:正在跑多 step agent 且每月 OpenAI/Anthropic 账单过千美元的团队,以及把 MCP 当标准基础设施的开发者。需要验证的是压缩率在不同任务类型上的稳定性,代码和日志类输入通常比创意写作类更容易压缩。
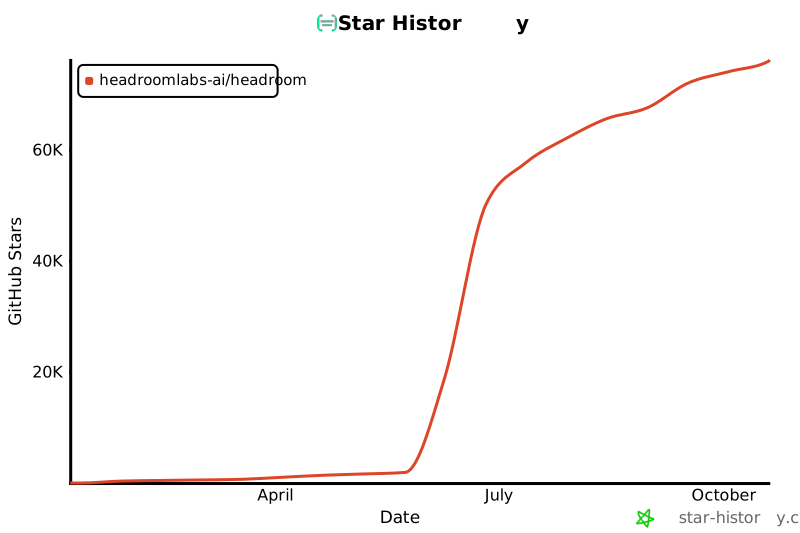
AI Agent基础设施层的输入压缩中间件,降低LLM调用成本
独特价值:本地化token压缩,编码场景降本80%+,无需外发数据