用门控蒸馏让RL策略迁移更精准
推荐指数 60.0 NO. 022 · 2026.10.17
upvotes449comments3
为什么值得看
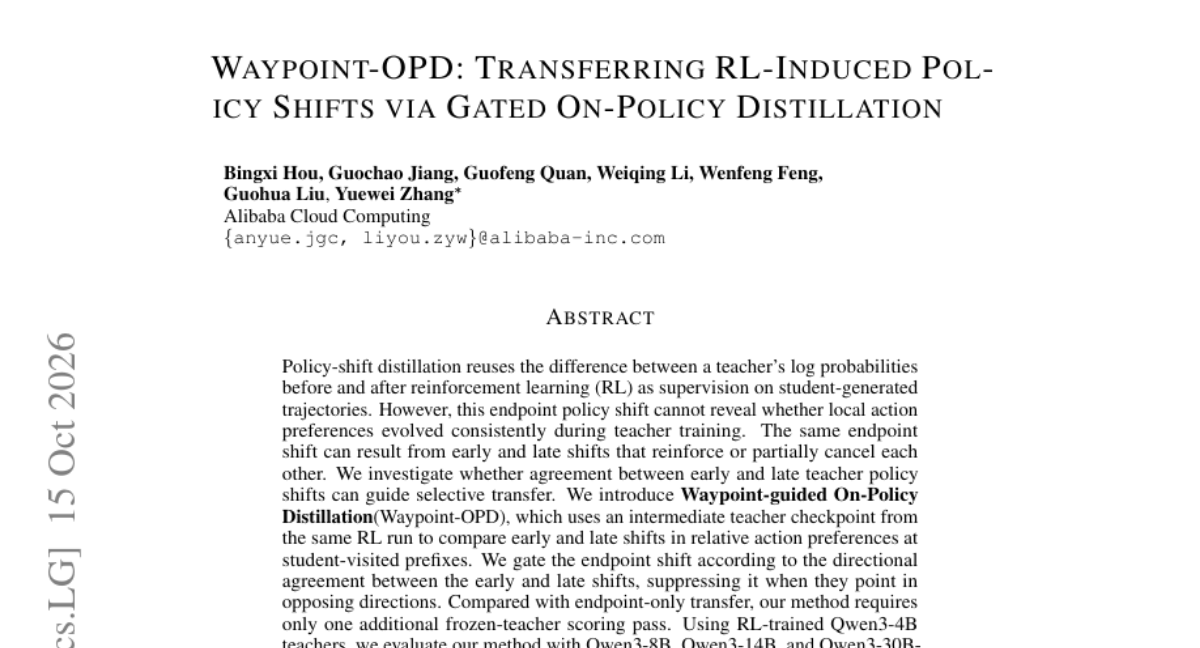
Waypoint-OPD通过检测教师模型训练早期与晚期策略变化的方向一致性,过滤掉相互抵消的噪声信号,提升策略蒸馏效果。推理任务上性能提升明显,且额外计算开销极小,适合资源受限场景部署。
媒体预览
编辑判断
传统策略蒸馏只拿RL训练前后的终点差异当监督信号,但教师模型中间过程可能反复横跳——早期学到的偏好后期又被覆盖,终点差值看着很大,实际信息熵很低。这篇论文的门控机制本质上是在做"时间维度上的梯度一致性检验",跟模型融合里的权重平均(如Model Soups、Exponential Moving Average)有相通之处,但用在蒸馏场景是新的。
实验显示在推理任务上提升显著,但论文没明确说用了多大的教师模型、学生模型压缩比多少。如果7B蒸馏到1B能有这个效果,端侧部署价值很大;如果是70B到7B,意义就窄很多。建议等代码开源后先看teacher-student的size gap和训练步数,再决定要不要跟进复现。
HuggingFace上449赞但仅3条评论,说明社区"觉得有用"但还没人跑通,窗口期大概一到两周。