视频理解评测缺统一标准?OmniCompass 补上了
推荐指数 61.0 NO. 021 · 2026.10.17
upvotes563comments3
为什么值得看
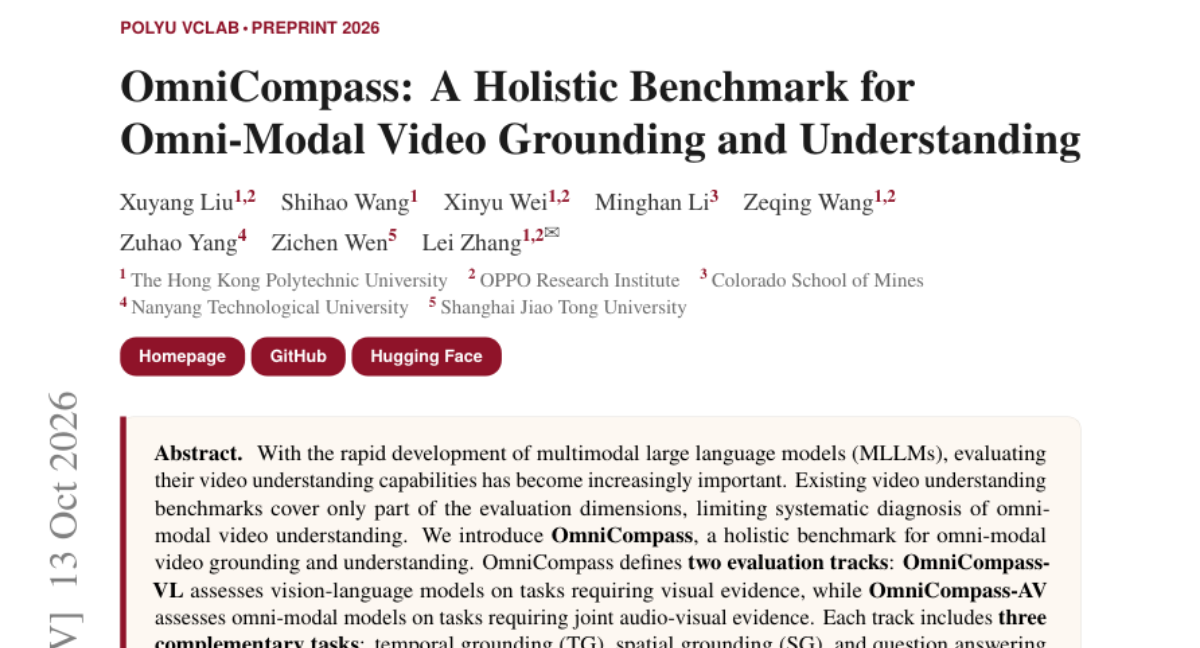
OmniCompass 是一个全模态视频理解基准测试,覆盖视觉-语言和音频-视觉推理的时间定位、空间定位和问答任务。现有评测维度碎片化,它首次把视频理解能力拆成可系统诊断的指标体系,对 MLLM 研发者来说是刚需工具。
媒体预览
编辑判断
视频理解领域长期被 ActivityNet-QA、MSRVTT 等零散评测割裂,研究者得跑五六个数据集才能摸清模型短板。OmniCompass 把时序定位、空间定位、跨模态问答统一到一个框架下,相当于给 MLLM 做了次全身体检。
从论文摘要看,它没提具体模型排名或 SOTA 数字,更像基础设施型工作。热度 563 upvotes 但评论仅 3 条,说明社区认可需求但还没形成讨论爆点。如果数据集和评测代码完整开源,预计会成为视频 MLLM 论文的标配引用。
做视频大模型或 Agent 的团队建议直接 fork 评测脚本,比起自己攒评测管线,能省至少两周工程时间。需要关注的是音频-视觉联合推理部分,这恰恰是当前 GPT-4V、Gemini 等闭源模型宣传最多但公开评测最少的能力盲区。