内存基础模型省66倍存储
推荐指数 72.0 NO. 004 · 2026.10.21
Stars192创建1 天前Forks5Issues2
简介
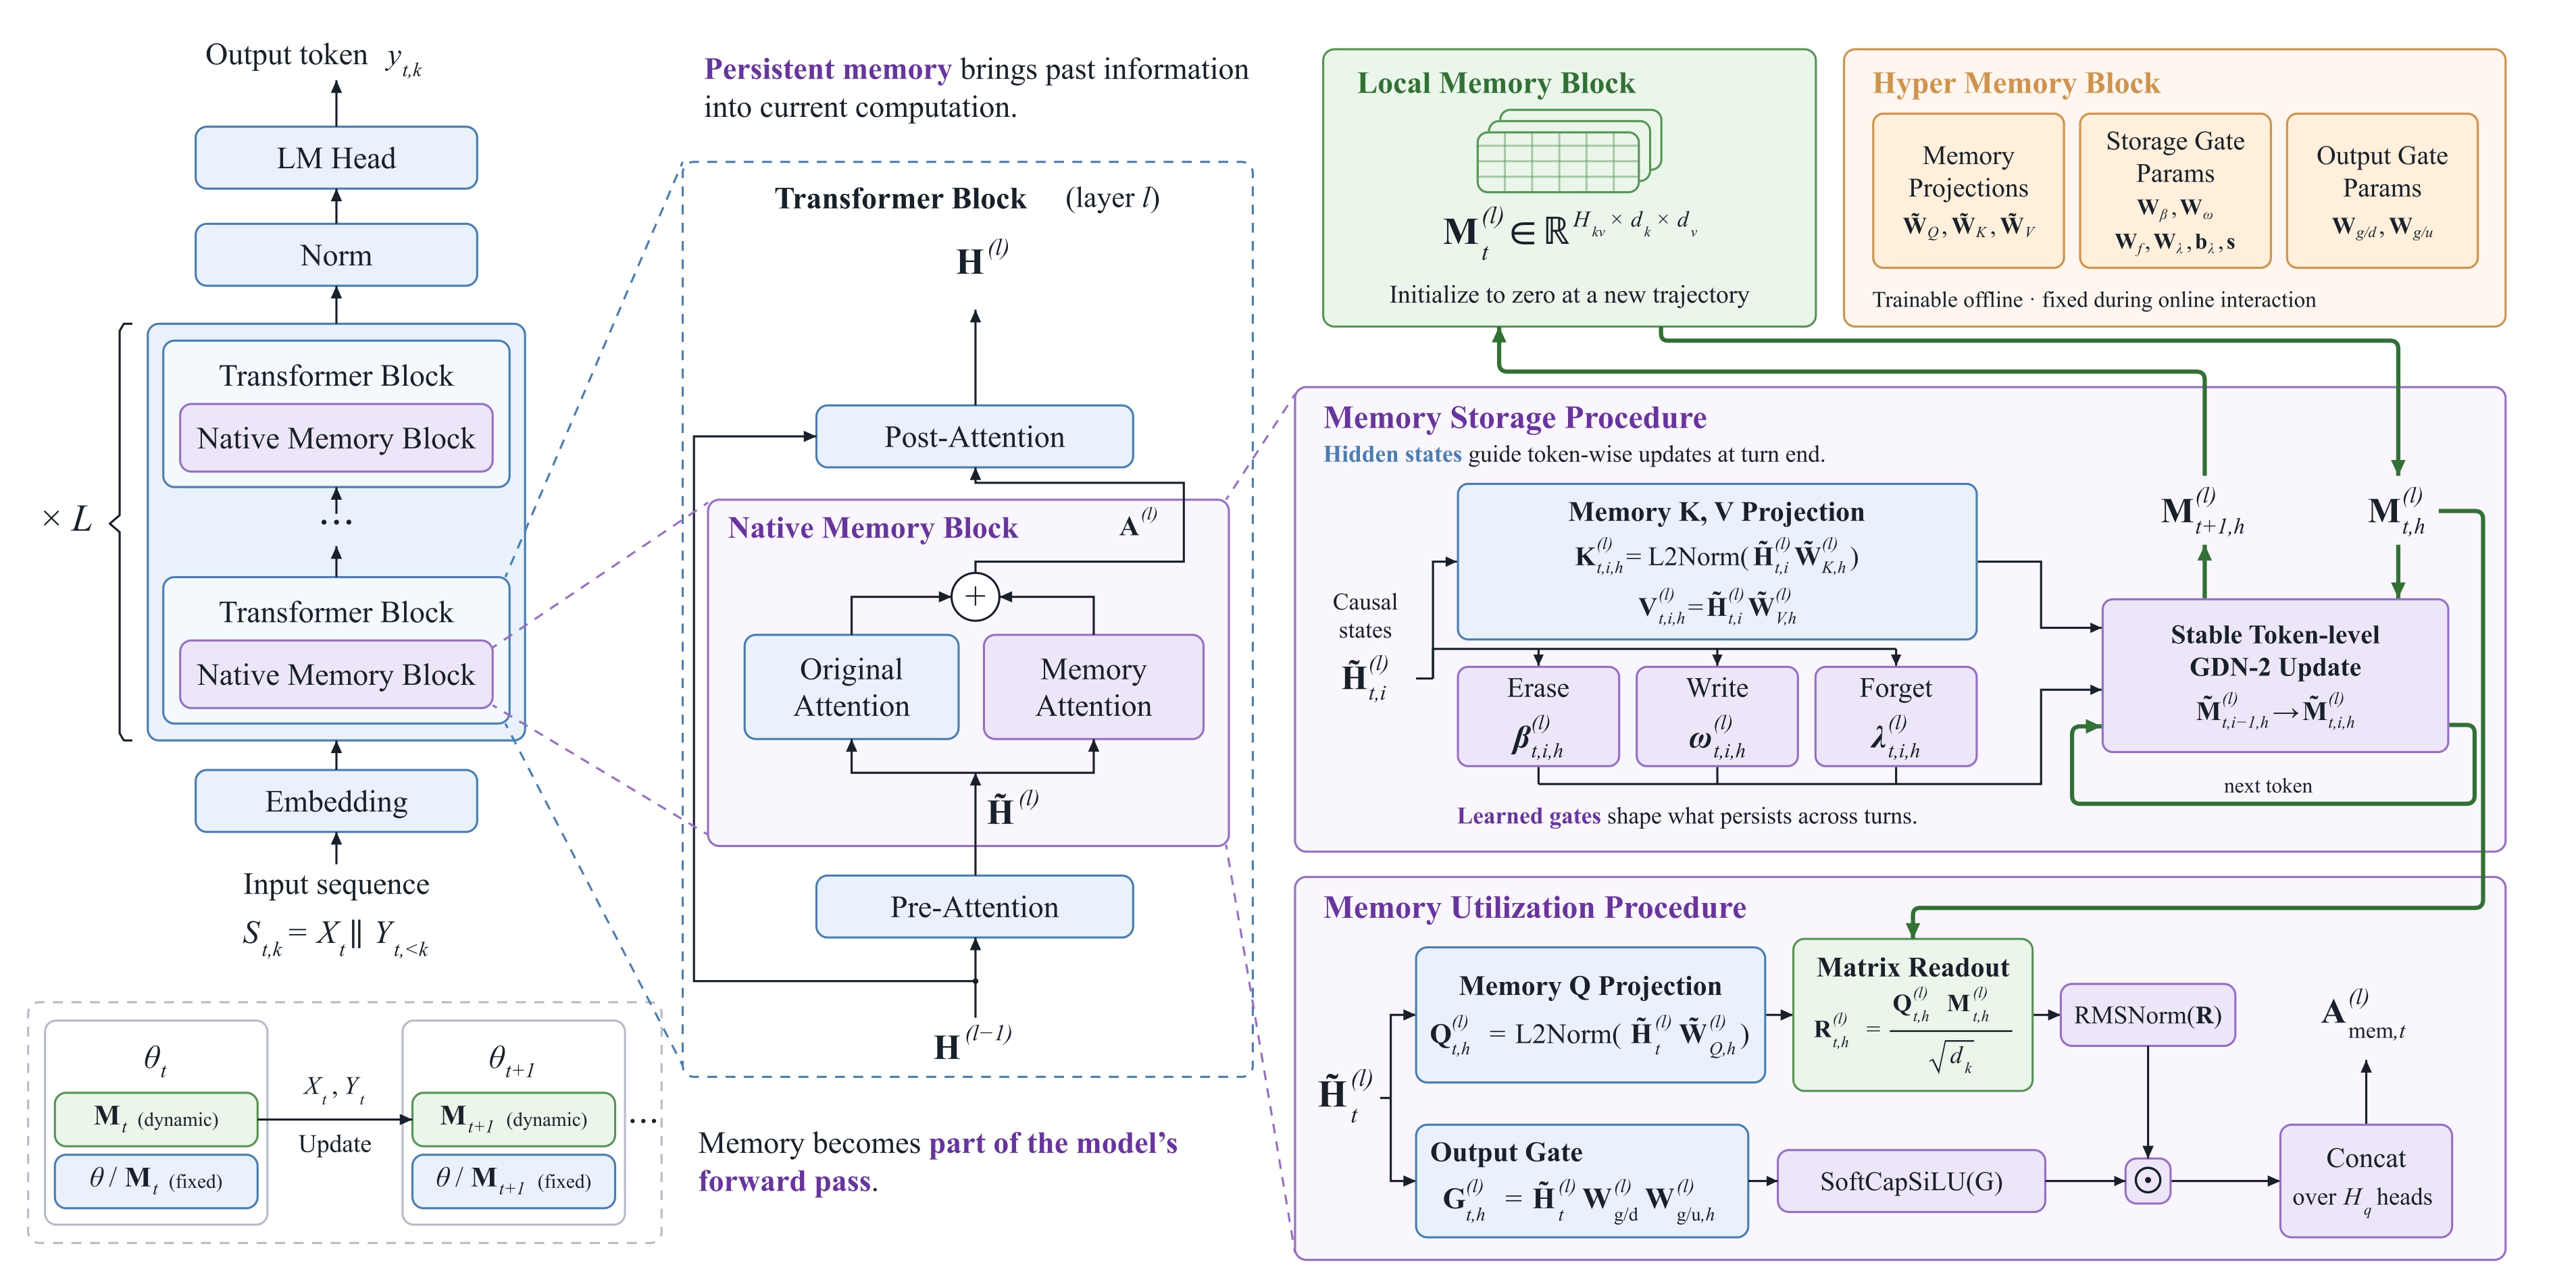
MemT-1.0 将持久化动态记忆内嵌为模型计算的一部分,通过固定大小的记忆状态替代完整 KV Cache,128K 上下文下存储减少约 66 倍。对长上下文推理成本敏感的团队可直接降低显存瓶颈。
Official repository for MemT-1.0
媒体预览
编辑判断
长上下文推理的显存爆炸问题,目前主流解法是靠 HBM 扩容或稀疏注意力近似,但成本曲线陡峭。MemT-1.0 的 fixed-size persistent state 思路与 RWKV 的状态压缩、Mamba 的 SSM 有相似动机,但明确给出了 128K 下的 66x 压缩比量化数据,且保留了可训练的超记忆模块,比纯启发式压缩更灵活。
Mixture-of-Storage 的架构暗示记忆容量可以横向扩展,这对需要小时级甚至天级会话记忆的 Agent 场景很关键。目前 stars 仅 192,代码完整度待验证,但方向切中了长上下文落地的真痛点。做长窗口客服、代码助手、研究 Agent 的团队建议跟踪其两阶段训练的具体配置和下游任务评测。
Star History
生态分析
Experimental
面向长上下文推理的模型级记忆压缩基础设施,非应用层Agent框架
独特价值:以固定记忆状态替代KV Cache,128K上下文显存降低66倍