推理模型自训练防崩溃新方法
推荐指数 78.0 NO. 019 · 2026.09.09
upvotes58comments1
为什么值得看
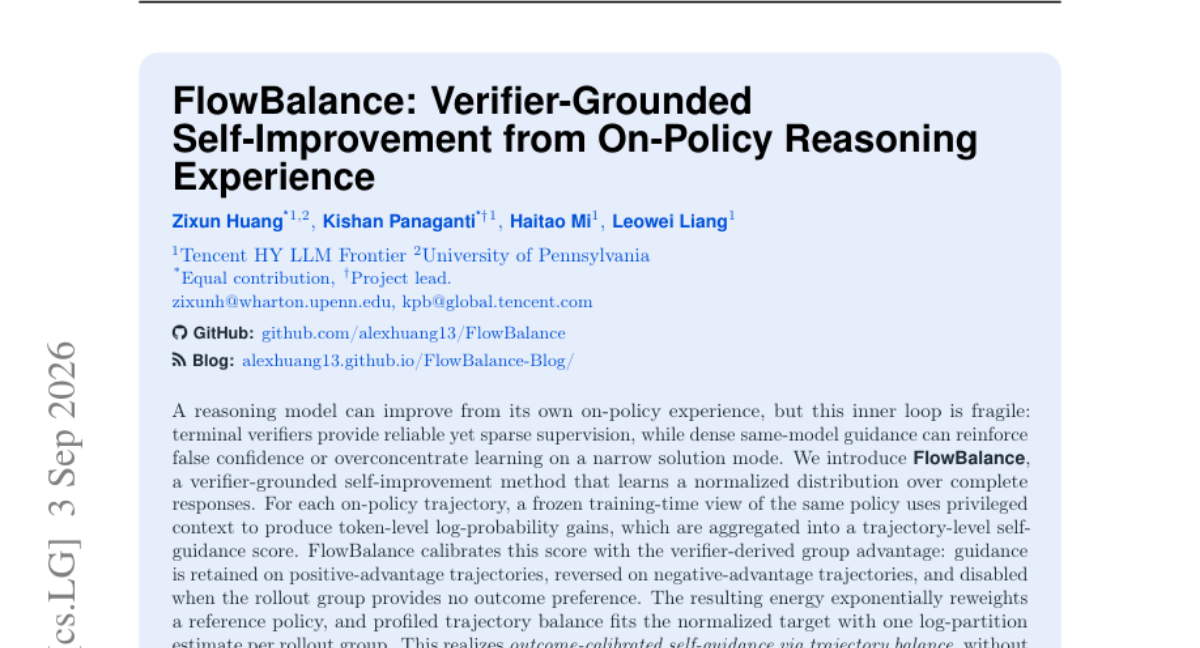
FlowBalance 让推理模型通过自身生成的轨迹数据自我改进,用冻结的旧版本模型提供密集监督、终端验证器提供稀疏但可靠的校准,避免传统自训练中的虚假自信或模式坍塌。对正在做 RLHF 或推理模型 post-training 的团队有直接参考价值。
媒体预览
编辑判断
当前推理模型的 self-play 训练普遍面临一个死循环:模型越训越自信,但自信的方向可能是错的,最终 collapse 到单一解法模式。FlowBalance 的关键设计是"用过去的自己监督现在的自己"——冻结一个训练快照作为密集引导,同时用终端验证器做最终校准,这比纯 REINFORCE 或纯 DPO 更稳定。
从工程角度看,这个方法需要维护两个模型副本(当前策略 + 冻结参考),显存开销会翻倍,但不需要额外的奖励模型或人类标注。如果你已经在用 GRPO 或 PPO 做数学/代码推理的后训练,这个轨迹级重加权机制可以比较无痛地接入现有管线。论文没有明确说开源时间,但 HuggingFace 挂了页面,代码值得蹲一下。