扩散模型让LLM推理无损并行加速
推荐指数 75.0 NO. 020 · 2026.09.09
upvotes74comments6
为什么值得看
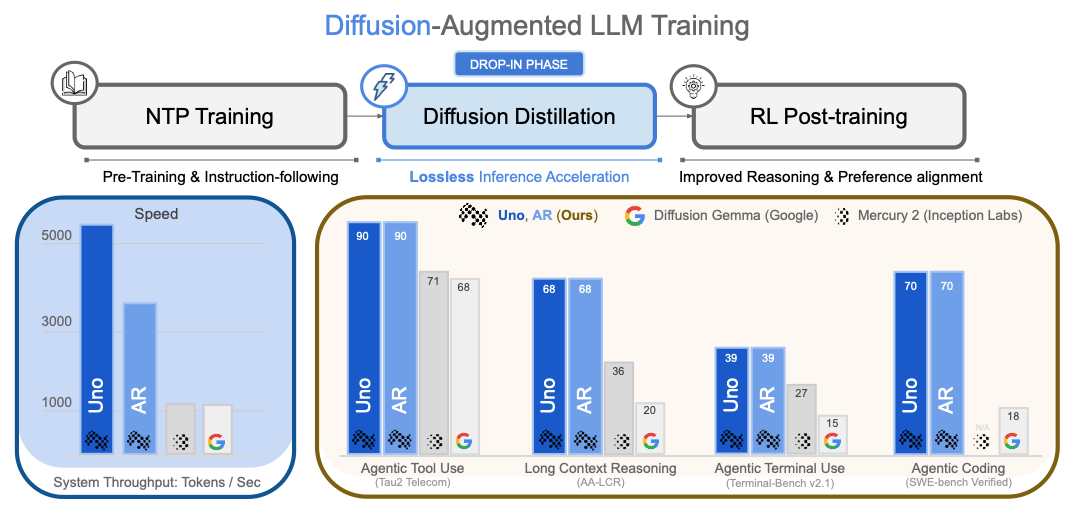
将离散扩散模型嫁接到自回归LLM上,用轻量级扩散权重实现多token并行采样,无需草稿模型或质量损失。对推理成本敏感的AI工程团队是潜在替代方案。
媒体预览
编辑判断
当前推理加速的主流路线是投机采样(Medusa、Lookahead等)和多头注意力改造,但都依赖草稿模型或修改KV Cache结构,部署复杂度高。这篇的关键在于解耦训练:AR权重完全不动,只额外蒸馏一小套扩散权重,现有模型可以热插拔。74 upvotes在HF Papers里算高热度,但注意作者没放代码——如果复现困难,实际落地会打折扣。建议先盯开源进度,有代码后优先在短序列生成场景(代码补全、SQL生成)测试,这类场景对latency最敏感且token间依赖相对局部。