面向Agent的极速推理引擎开源
推荐指数 58.0 NO. 006 · 2026.10.16
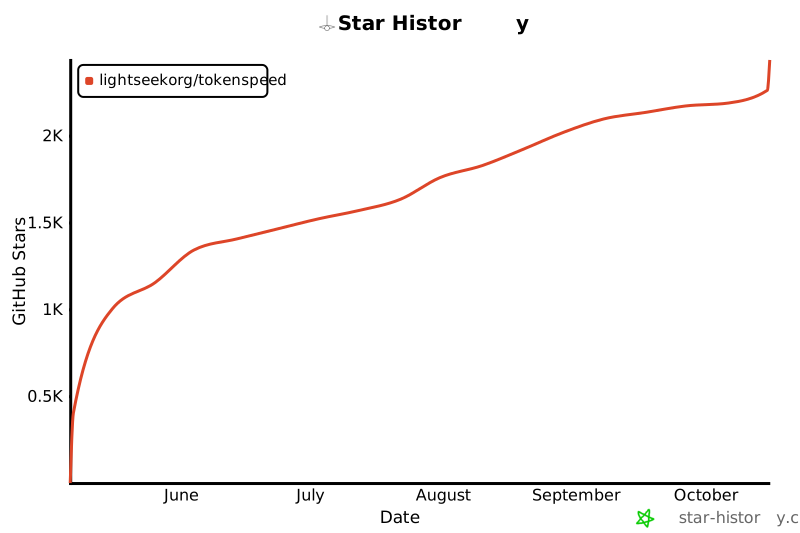
Stars2,436
为什么值得看
TokenSpeed 是一个专为 Agent 工作负载设计的 LLM 推理引擎,目标在 TensorRT-LLM 的性能和 vLLM 的易用性之间取平衡。核心亮点是用 C++ 类型系统在编译期保证 KV cache 安全复用,以及针对 Blackwell 架构优化的 MLA 内核。
TokenSpeed is a speed-of-light LLM inference engine.
媒体预览
编辑判断
Agent 场景的核心痛点不是吞吐而是长尾延迟——多轮工具调用中 KV cache 频繁分配释放容易成为瓶颈。TokenSpeed 把请求生命周期和缓存所有权做成编译期状态机,相当于用 Rust 的思路解决 C++ 的内存安全问题,这比 vLLM 的 Python 调度层更硬核。
目前生产级 Agent 推理大多在 vLLM 和 TensorRT-LLM 之间二选一:vLLM 灵活但 Python 开销大,TensorRT-LLM 快但闭坑成本高。TokenSpeed 的 SMG-integrated AsyncLLM 入口设计暗示它想兼容 vLLM 的 API 生态,降低迁移成本。
如果你在搭 Agent 平台且延迟敏感(比如实时编码助手、多轮对话客服),可以关注它的 MLA 在 Blackwell 上的 benchmark。不过 2400 star 尚早,建议等有人跑出和 vLLM 的端到端对比再决定是否投入生产。
Star History
生态分析
Experimental
填补TensorRT-LLM性能与vLLM易用性之间的Agent推理引擎空白
独特价值:编译期KV cache安全复用+Blackwell MLA内核,专为Agent负载优化
竞品: