NVIDIA 开源一站式模型压缩工具
ModelOpt 是 NVIDIA 官方推出的模型优化库,集成量化、剪枝、蒸馏、投机解码等 6 种压缩技术,统一支持 Hugging Face、PyTorch、ONNX 模型输入。对需要部署大模型到生产环境的团队,意味着不用在 TensorRT、AutoGPTQ、vLLM 等工具之间来回切换了。
A unified library of SOTA model optimization techniques like quantization, distillation, pruning, neural architecture search, speculative decoding, etc. It compresses deep learning models for downstream deployment frameworks like TensorRT-LLM, TensorRT, vLLM, etc. to optimize inference speed.
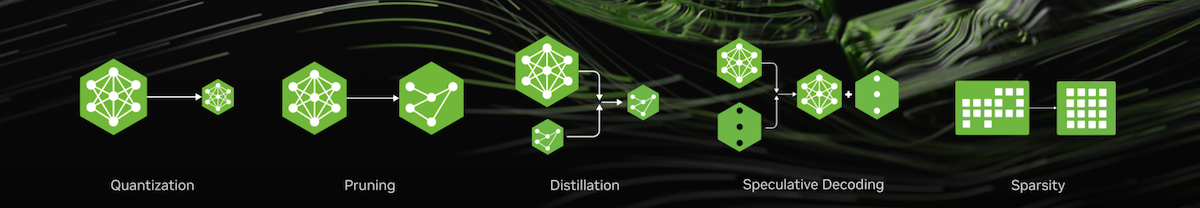
做模型部署的工程师之前通常要维护多套工具链:用 AutoGPTQ 做 4-bit 量化、用 vLLM 做投机解码、再用 TensorRT 做最终加速,兼容性问题频发。ModelOpt 的核心价值是把 NVIDIA 内部验证过的优化路径打包成统一 API,而且明确支持了近期热门的 FP8 和稀疏化(2:4 structured sparsity)。
跟微软的 Olive 或 Intel 的 Neural Compressor 相比,ModelOpt 的差异化在于深度绑定 CUDA 生态,优化后的模型可以直接进 TensorRT-LLM 推理,省去中间转换层。如果你已经在用 A100/H100 做 serving,这个工具比社区方案更省调优时间。
建议重点关注它的 NAS 和蒸馏模块,这两块在开源社区一直缺乏工业级实现,NVIDIA 放出来可能是为了配合自家 DGX Cloud 的微调服务做生态锁定。
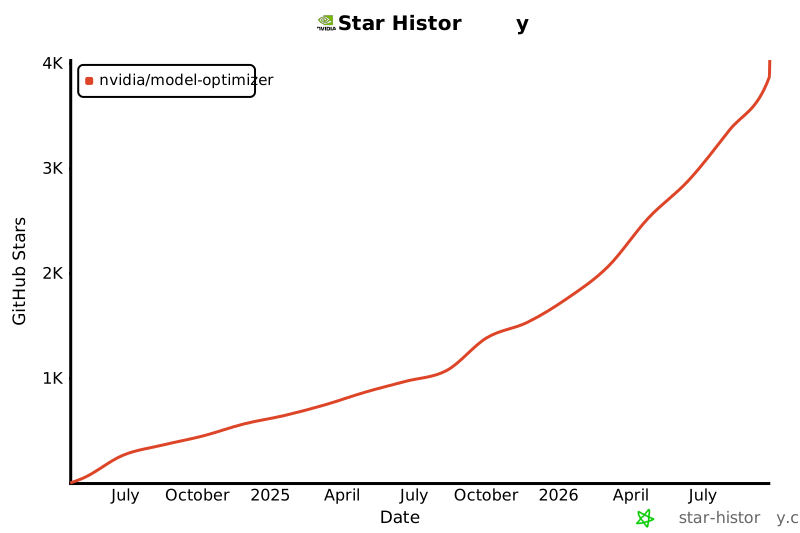
NVIDIA部署生态的核心模型压缩层,衔接训练框架与TensorRT/vLLM推理引擎
独特价值:唯一统一集成六种SOTA压缩技术并原生对接NVIDIA推理栈的优化库