巴西首个开源葡语大模型1.7B
推荐指数 50.0 NO. 005 · 2026.09.06
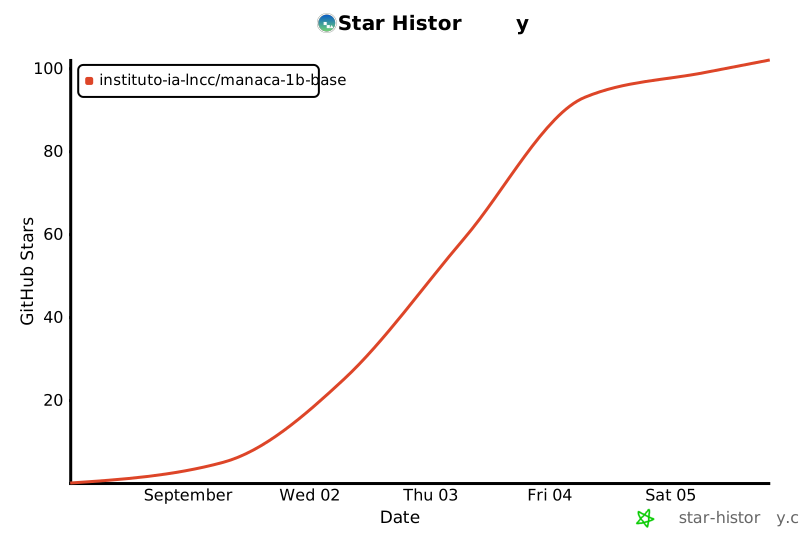
Stars102创建5 天前Forks6Issues2
为什么值得看
Manacá-1B 是专为巴西葡萄牙语从零训练的 17 亿参数 decoder-only 模型,采用全容器化可复现流水线。对做多语言或拉美市场的团队有参考价值,尤其关注小语种训练基础设施的工程实现。
LLM aberto e reprodutível para o Português do Brasil An Open, Reproducible Brazilian-Portuguese Language Model
媒体预览
编辑判断
小语种 LLM 训练最大的坑不是数据量而是 tokenizer 和预训练目标的错位,很多团队直接用多语言模型微调导致语法和 cultural nuance 丢失。Manacá 的 pipeline 用全容器化解决 reproducibility,这对学术复现和合规审计很关键,但 102 stars 说明社区还在早期验证阶段。
对比 Mistral 或 Aya 这类欧洲/多语言优先的模型,Manacá 的真正差异化是「从零训练」而非微调,这能避免英语语法的殖民残留。如果你在考虑越南语、泰语等小语种的基座模型方案,可以 fork 他们的 Dockerfile 和 tokenizer 配置作为起点,而不是从头造轮子。
Star History
生态分析
Experimental
拉美葡语区稀缺的小语种开源基座模型,填补巴西葡萄牙语专用LLM空白
独特价值:全容器化可复现训练流程,为小语种LLM工程化提供基础设施范式