70B模型4GB显存运行,无需量化
推荐指数 65.0 NO. 002 · 2026.10.12
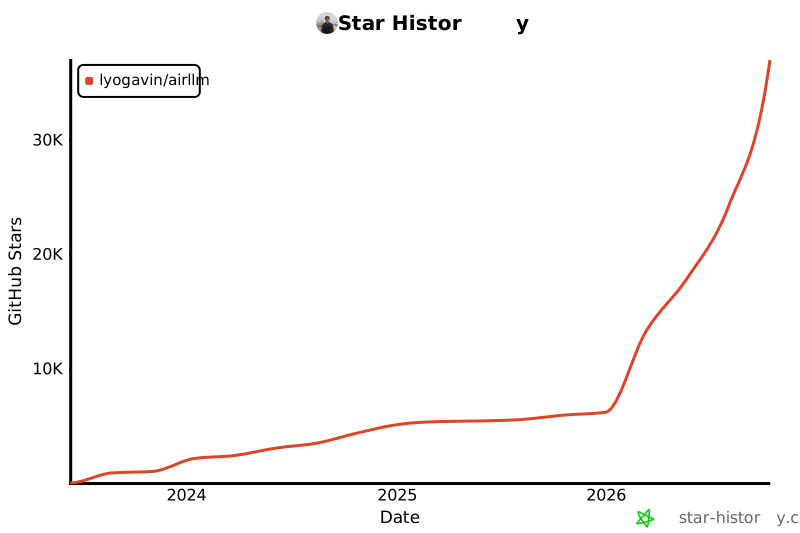
Stars36,379
为什么值得看
AirLLM通过层卸载技术将推理内存压缩到极致,Kimi K3(2.8T)可跑在4GB显存,DeepSeek-V3仅需约12GB。对GPU预算有限的中小团队和本地部署开发者是刚需级方案。
AirLLM 70B inference with single 4GB GPU
媒体预览
编辑判断
层卸载(layer offloading)不是新概念,vLLM、DeepSpeed-Inference 都做过,但 AirLLM 的激进之处在于把激活值也做了极致压缩,实现了比 DeepSpeed ZeRO-Inference 更高的内存压缩比,代价是推理延迟显著增加。之前大家解决大模型小显存问题主要靠 GGUF/GPTQ 量化,但 4-bit 量化对 70B+ 模型的精度损失在复杂推理任务上仍然明显。AirLLM 走了一条不损精度的路线,适合对输出质量敏感、但能容忍慢速推理的场景,比如离线批量生成、长文档分析。如果你在用 Ollama/llama.cpp 跑量化版 DeepSeek 且对效果不满意,这个值得对比测试。
Star History
生态分析
Production
大模型推理内存压缩工具,专注极致显存优化与消费级GPU部署
独特价值:层卸载技术实现Kimi K3 2.8T/4GB显存运行,业界极致压缩比
竞品: